<p align="center">
  <a href="https://www.kagura-ai.com/ja/">
    <picture>
      <source media="(prefers-color-scheme: dark)" srcset="docs/assets/social-preview.png">
      <img src="docs/assets/readme-banner.png" alt="Kagura Memory Cloud — AI エージェントとチームのための適応的メモリ、RAG を超えて" width="820">
    </picture>
  </a>
</p>

<p align="center">
  <a href="README.md">English</a> · 日本語
</p>

<p align="center">
  <strong>AI エージェントとチームのための適応的メモリ</strong> — セルフホスト、RAG を超えて。<br>
  検索するたびに賢くなる MCP サーバー:<br>
  ハイブリッド検索 + どのメモリ同士が関連するかを学習する neural memory graph。
</p>

<p align="center">
  <a href="LICENSE"><img src="https://img.shields.io/badge/License-Apache_2.0-blue.svg" alt="License"></a>
  <a href="https://github.com/kagura-ai/memory-cloud/actions/workflows/ci.yml"><img src="https://github.com/kagura-ai/memory-cloud/actions/workflows/ci.yml/badge.svg" alt="CI"></a>
  <a href="https://codecov.io/gh/kagura-ai/memory-cloud"><img src="https://codecov.io/gh/kagura-ai/memory-cloud/graph/badge.svg" alt="codecov"></a>
  <a href="https://www.python.org/downloads/"><img src="https://img.shields.io/badge/python-3.11+-blue.svg" alt="Python 3.11+"></a>
  <a href="https://nodejs.org/"><img src="https://img.shields.io/badge/node.js-20+-green.svg" alt="Node.js 20+"></a>
  <a href="https://modelcontextprotocol.io/"><img src="https://img.shields.io/badge/MCP-Streamable_HTTP-purple.svg" alt="MCP"></a>
  <a href="https://safeskill.dev/scan/kagura-ai-memory-cloud"><img src="https://img.shields.io/badge/SafeSkill-90%2F100_Verified%20Safe-brightgreen" alt="SafeSkill 90/100"></a>
</p>

<p align="center">
  Claude、ChatGPT、Gemini、その他あらゆる MCP 互換クライアントで動作。<br>
  <a href="https://github.com/kagura-ai/kagura-memory-python-sdk"><strong>Python SDK（KaguraClient・REST クライアント・FileIngestor）</strong></a>
</p>

<p align="center">
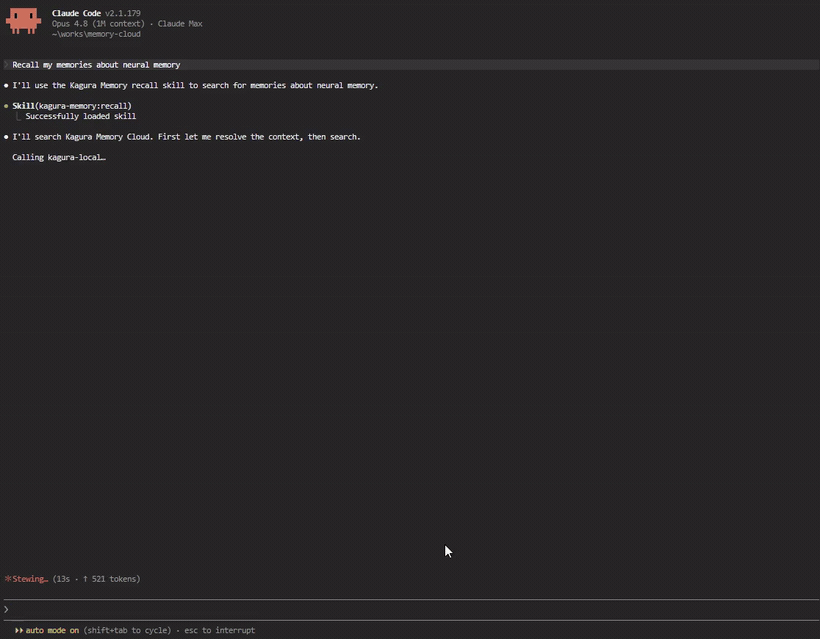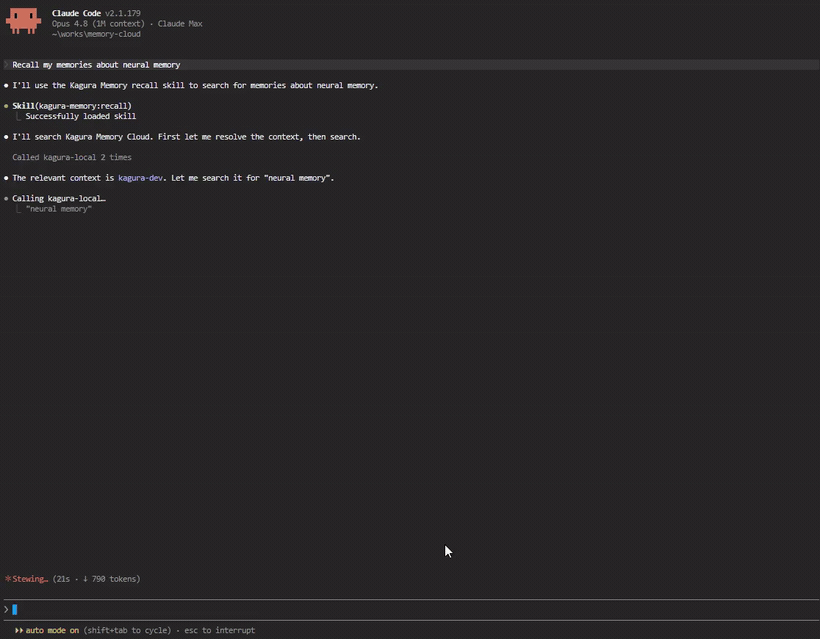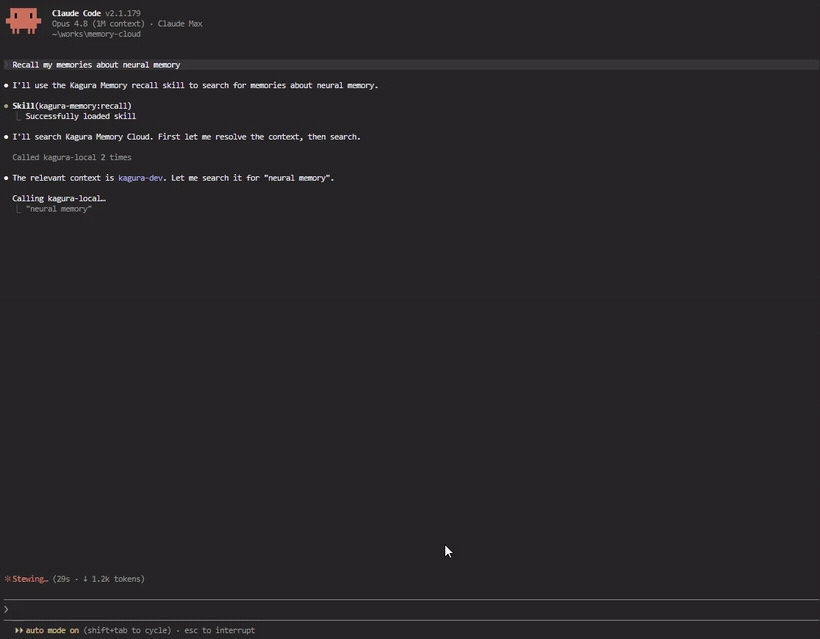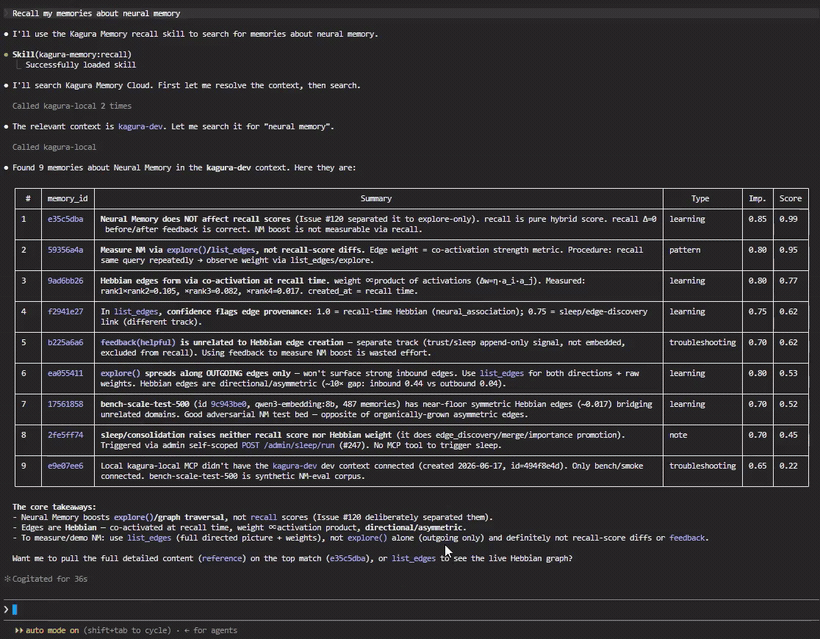
  <a href="https://www.kagura-ai.com/demo/terminal-en-cli-2x.mp4">
    <img src="docs/assets/cli-demo.gif" alt="Claude Code から Kagura Memory を MCP 経由で recall" width="760">
  </a>
  <br>
  <em>Claude Code から過去のメモリを recall — MCP 経由の Kagura Memory。<a href="https://www.kagura-ai.com/demo/terminal-en-cli-2x.mp4">▶ デモを見る</a></em>
</p>

## なぜ Kagura Memory Cloud か？

> **AI は会話のたびに全てを忘れる。Kagura はそれを解決し、検索するたびに賢くなる。**

多くの AI メモリツールはベクトル DB にチャット UI を被せただけ。Kagura は違います — Karpathy の [LLM Wiki](https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f) パターンを **チーム規模で完全実装**:

| アプローチ | ストレージ | 複利成長 (compounding) | 規模 |
|---|---|---|---|
| Vector DB / RAG | embedded chunks | なし — 取得専用 | 任意 |
| Karpathy の LLM Wiki | markdown ファイル | LLM がページを書き換え | 個人 (約 100 ページ) |
| **Kagura Memory Cloud** | **PostgreSQL + Qdrant + Neural graph** | **Hebbian + Sleep Maintenance** | **チーム / 組織** |


| 機能 | 説明 |
|------|------|
| **Adaptive Memory** | 検索のたびに関連メモリ間の接続が自動強化。使うほど `explore()` が隠れた関連性を発見する精度が上がる |
| **Hybrid Search** | Semantic (OpenAI / セルフホスト) + BM25 キーワード — top-1 精度 96% |
| **AI Reranking** | セルフホスト (Ollama/vLLM — ローカル・無料)、Voyage AI、Cohere — cross-encoder reranker で精度向上 |
| **Neural Memory Graph** | Hebbian 学習がバックグラウンドで知識グラフを構築。`explore()` がそれを辿り偶発的発見を提供 |
| **Agent Memory Substrate** | 単なる知識ストアを超えて — delivery mode (pin / 時刻トリガ)、サーバー署名の trust boundary、agent state レーン、retrieval feedback シグナル。自律エージェントのループに必要なプリミティブ群 |
| **Agent Control Plane (preview)** | Workspace スコープの Agent Registry、減算的な context binding、agent-bound member key、ライフサイクル kill switch、1 呼出の session bootstrap。v0.49.0 で導入 |
| **63 の MCP ツール** | Memory、Agent Substrate、Agent Control Plane、Neural edges、Contexts、Tags、Files (R2)、Analyses (メモリー分析)、Resources、Secrets、Sleep Maintenance、Usage、API-Key Bindings |
| **マルチプロバイダ** | 埋め込みに OpenAI かセルフホスト (Ollama、vLLM — ローカル・非公開・コストゼロ) |
| **チーム対応** | Workspace、RBAC、context 分離、共有メモリ |
| **Web UI** | Next.js ダッシュボード — context、検索設定、メンバー管理 |
| **5 分セットアップ** | `./setup.sh` のみ |

## アーキテクチャ

```
Workspace (チーム/組織)
├── Context A ("my-project")     ← フォルダのような単位
│   ├── Memory 1                 ← 3 層構造: summary / context / content
│   ├── Memory 2
│   └── Neural edges (Hebbian)   ← 自動接続
├── Context B ("learning-notes")
│   └── ...
└── Members (Owner/Admin/Member/Viewer)
```

### LLM Knowledge Base — 5 層実装

Karpathy の [LLM Wiki パターン](https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f) は「生きた知識ベース」を 5 層で記述しています (RAG を超えるパターン)。Kagura はこの 5 層全てをチーム規模で実装:

| Layer | Kagura の実装 | Karpathy パターンとの違い |
|---|---|---|
| **Ingest** | REST `/api/v1/memory`、MCP `remember`、R2 ファイルストレージ、resource tokens | + バイナリ blob、+ マルチテナント |
| **Compile** | **MCP-as-compile-API** — chat agent が構造化 tool call (`remember(summary, content, type, tags)`) で compile + Sleep Maintenance がバッチ統合 | バッチ wiki 書き換えではなく連続マイクロ compile — schema 強制 |
| **Index** | 三重 index: **BM25** (keyword) + **Qdrant** (semantic) + **Hebbian graph** (relational) — 全自動維持 | 手動の `index.md` メンテ不要 |
| **Query** | Hybrid Search + AI Reranker + `explore` グラフ探索 | markdown grep を超え、semantic + relational query をサポート |
| **Enhance** | **Hebbian 学習** — `recall()` のたびに共起 memory 間の edge が強化。Sleep Maintenance が定期統合 | LLM コストゼロのバックグラウンド成長 (LLM による page 書き換えと違う) |

**Compounding loop**: 現状は明示的 (user/agent が回答合成後に `remember()` を呼ぶ)。回答の自動書き戻しはノイズを抑えるため意図的に opt-in。


### Adaptive Memory: 2 つの検索経路

Kagura は **精密検索** と **発見** を独立した 2 経路に分け、それぞれを用途特化で最適化:

```
recall()  ──→ Hybrid Search (semantic + BM25) ──→ [Reranker] ──→ 精密結果
                      │
                      └──→ Hebbian 学習 (バックグラウンド) ──→ グラフ edge が成長
                                                                 │
explore() ──→ グラフ探索 (Neural Memory) ←───────────────────────┘  関連発見
```

- **`recall()`** — 精密検索。Hybrid (semantic 60% + BM25 40%) + 任意の AI reranking。最も関連度の高いメモリを返す
- **`explore()`** — 発見。Neural Memory グラフを辿り、キーワード検索では拾えない関連メモリを見つける
- **Hebbian 学習** — `recall()` のたびに共起したメモリ間の edge が暗黙に強化。明示的な学習不要で、使うほどグラフが有機的に成長

この分離は意図的です。グラフ信号を recall に混ぜると精度が落ちる ([ベンチマーク検証済み](docs/neural-memory-evaluation.md))。各経路が自分の得意領域に集中する設計。

**データ分離:** 全データは `workspace_id → context_id → user_id` でフィルタ。境界を越えた漏洩なし。Qdrant は単一 collection + payload filtering。

**技術スタック:** FastAPI (async) · PostgreSQL · Qdrant · Redis · Next.js 16 · OAuth2 · MCP over Streamable HTTP

## クイックスタート

### 動作要件

|  | 最小 | 推奨 |
|--|------|------|
| CPU | 2 コア | 4 コア以上 |
| RAM | 4 GB | 8 GB 以上 |
| ディスク | 10 GB 空き | 20 GB 以上 空き |

### 前提

- Docker と Docker Compose
- Python 3.11+
- Node.js 20+
- 埋め込み用 OpenAI API キー — またはセルフホスト推論サーバー (例: Ollama) によるローカル埋め込み
- OAuth2 クレデンシャル (任意 — OAuth 無しでもパスワード + MFA ログイン可)

### セットアップ

**ワンライナー:**

```bash
git clone https://github.com/kagura-ai/memory-cloud.git
cd memory-cloud
./setup.sh
```

**Claude Code 併用:**

```bash
git clone https://github.com/kagura-ai/memory-cloud.git
cd memory-cloud
claude   # 起動後 /setup
```

**ステップ個別実行:**

```bash
# 1. Clone
git clone https://github.com/kagura-ai/memory-cloud.git
cd memory-cloud

# 2. 環境設定 (secrets 生成、API キー入力)
(cd backend && python3 -m src.cli.setup_env)

# 3. サービス起動
docker compose up -d

# 4. マイグレーション
(cd backend && alembic upgrade head)

# 5. admin 作成 (対話式 — パスワード/MFA/API キー/埋め込みプロバイダ設定)
(cd backend && python3 -m src.cli.create_admin)

# Backend API:  http://localhost:8080
# Frontend UI:  http://localhost:3000
# API docs:     http://localhost:8080/redoc
```

**`.env.local` 設定** (`setup_env` が自動構成):

| 設定 | 必須 | 説明 |
|------|------|------|
| `API_KEY_SECRET` | **必須** | API キー暗号化用 secret (自動生成) |
| `JWT_SECRET` | **必須** | JWT トークン用 secret (自動生成) |
| `OPENAI_API_KEY` | **必須**\* | 埋め込み用 OpenAI API キー |
| `SELF_HOSTED_BASE_URL` | 任意 | セルフホストバックエンド URL (既定: `http://localhost:11434`) |
| `EMBEDDING_PROVIDER` | 任意 | `openai` (既定) または `self_hosted` |
| `GOOGLE_CLIENT_ID/SECRET` | 任意 | Google OAuth2 ログイン (任意 — パスワードログインも可) |
| `GITHUB_CLIENT_ID/SECRET` | 任意 | GitHub OAuth2 ログイン (任意) |

\* メモリ機能には `OPENAI_API_KEY` または稼働中のセルフホスト推論サーバー (例: Ollama) が必要。

### Admin CLI

| コマンド | 用途 |
|----------|------|
| `python3 -m src.cli.setup_env` | secrets 生成 + `.env.local` 構成 (Docker 起動前) |
| `python3 -m src.cli.create_admin` | admin + workspace + API キー + `.mcp.json` + 埋め込み設定 |
| `python3 -m src.cli.reset_password` | パスワード / MFA リセット |
| `python3 -m src.cli.delete_admin` | admin 削除 (再作成用) |

> `backend/` ディレクトリで実行。Docker API コンテナの起動が必須。

## MCP クライアント設定

Claude Code / Claude Desktop / Claude Chat / ChatGPT / Gemini CLI ほか、Streamable HTTP 対応の任意の MCP クライアントから接続できます。

**Claude Code(3 ステップ):**

1. サービスを起動し `http://localhost:3000/workspace/integrations/api-keys` で API キーを作成
2. `.mcp.json.example` を `.mcp.json` にコピーし、workspace ID と API キーを設定:

```bash
cp .mcp.json.example .mcp.json
# .mcp.json を編集 — URL の workspace_id と API キーを入れる
```

3. Claude Code を再起動して動作確認(`recall` / `remember` が呼べれば OK)

> `.mcp.json` は `.gitignore` 済み — API キーを含むためコミット禁止。

各クライアントの詳細設定・メモリ同期フック・`.claude/` テンプレート・WSL2 ネットワーク注意点は **[MCP Client Setup](docs/mcp-clients.md)**(英語)を参照してください。

## MCP ツール

**13 カテゴリ 63 ツール**: Memory(`remember` / `recall` / `explore` …)、Agent Substrate、Agent Control Plane(preview)、Neural Edges、Contexts、Tags、Files (R2)、Analyses(メモリー分析)、Resources、Secrets(ゼロ知識)、Sleep Maintenance、Usage、API-Key Bindings — 各ツールにロール別アクセス制御。

ツールごとの詳細と必要ロール: **[MCP Tools Reference](docs/mcp-tools.md)**(英語)

## REST API

MCP ツールに加えてフル REST API を提供:

- **Memory**: remember、recall、reference、forget、explore (`/api/v1/memory/*`)
- **Contexts**: CRUD、検索設定 (`/api/v1/contexts/*`)
- **Agents (preview)**: Registry、context binding、composed bootstrap (`/api/v1/agents/*`)
- **Files**: R2 の presigned upload/download (`/api/v1/files/*`、最大 100 MiB)。旧 `/api/v1/attachments/*` は `410 Gone`
- **Analyses**: メモリー分析の preview/start/read/cancel (`/api/v1/analyses/*`)
- **Resources**: 外部 event 取込と resource 参照 (`/api/v1/resources/*`)
- **Workspaces**: 管理、メンバー、招待 (`/api/v1/workspaces/*`)
- **Admin**: ユーザ、プラン管理、neural config (`/api/v1/admin/*`)
- **Secrets**: ゼロ知識シークレットストア — ciphertext のみ、サーバーは復号しない (`/api/v1/config/secrets/*`)

完全な API ドキュメント: `http://localhost:8080/redoc`

## 認証

2 つの OAuth2 プロバイダをサポート:

- **Google OAuth2** — 任意。`GOOGLE_CLIENT_ID` と `GOOGLE_CLIENT_SECRET` を設定
- **GitHub OAuth2** — 任意。`GITHUB_CLIENT_ID` と `GITHUB_CLIENT_SECRET` を設定

プロバイダ間で同じメールアドレスのユーザは単一アカウントを共有。OAuth プロバイダなしでもパスワード + MFA ログインが利用できます。

## プランティア カスタマイズ

プランは workspace ごとのリソース上限(contexts / memories / MCP 呼出/日)を制御します。セルフホストの単独利用では自分の workspace に L (Pro) プランを割り当ててください。既定値・環境変数での上書き・Stripe 課金の有効化: **[Deployment → Plan Tiers](docs/deployment.md#plan-tiers)**(英語)

## Claude Code プラグイン

`kagura-memory` プラグインは Claude Code にセッション管理とメモリワークフロースキルを追加します。一度インストールすれば全プロジェクトで使えます。

**インストール:**

```bash
# マーケットプレイスから追加
/plugin marketplace add kagura-ai/memory-cloud
/plugin install kagura-memory@kagura-memory-cloud
```

**利用可能なスキル:**

| スキル | 説明 |
|--------|------|
| `/kagura-memory:session-start` | 前回のセッションコンテキストを復元 |
| `/kagura-memory:session-summary` | セッション終了前に知識を保存 |
| `/kagura-memory:recall` | 過去の知識を検索 |
| `/kagura-memory:remember` | 新しい知識を保存 |
| `/kagura-memory:guide` | 使い方ガイド・接続確認・セットアップ |
| `/kagura-memory:smoke-test` | 全 MCP ツールの動作確認 |

**推奨ワークフロー:**

```
/kagura-memory:session-start       # ← 開始: 前回コンテキストを復元
  ... 通常の作業 ...
/kagura-memory:recall              # 過去の設計判断 / パターン / 修正を検索
/kagura-memory:remember            # 重要な学びを都度保存
  ... 作業完了 ...
/kagura-memory:session-summary     # ← 終了: 次回のためにセッション知識を保存
```

スキルは MCP ツール (`recall`、`remember` 等) をワークフローロジックで包んだもの。context 選択、git 状態分析、構造化プロンプトが組込まれています。セッション管理やガイド付きワークフローはスキル、細かい操作は MCP ツール直接、という使い分けを推奨。

> **前提:** MCP 接続の設定が必要 (`.mcp.json` に API キー)。プロジェクトで `/kagura-memory:guide` を実行してセットアップ。

## ドキュメント

**API リファレンス** — 2 つの入口:

- **コンセプト (markdown)**: [API Reference](docs/api-reference.md) — 認証、ベース URL、MCP エンドポイント、リクエスト/レスポンス例
- **エンドポイント (ライブ)**: `http://localhost:8080/redoc` — FastAPI から自動生成、稼働バックエンドと常に同期

**コンセプトとガイド:**

- [MCP Client Setup](docs/mcp-clients.md) — 各クライアントの接続設定(英語)
- [MCP Tools Reference](docs/mcp-tools.md) — 全 63 ツールと必要ロール(英語)

- [Core Concepts](docs/concepts.md) — Workspace、Context、Memory、Neural Memory、MCP ツール
- [Architecture](docs/architecture.md) — システム設計とデータフロー
- [Getting Started](docs/getting-started.md) — 詳細セットアップガイド
- [Chunking Guide](docs/chunking-guide.md) — メモリ保存のベストプラクティス
- [Resource Tokens Guide](docs/resource-tokens-guide.md) — resource token 経由の外部データ取込
- [Neural Memory Evaluation](docs/neural-memory-evaluation.md) — ベンチマーク結果、設計判断
- [Search Quality Benchmark](docs/search-quality-benchmark.md) — 精度テスト、reranking、ベストプラクティス
- [Retrieval Feedback & Eval Gate](docs/eval/retrieval-feedback-and-eval-gate.md) — feedback シグナル + 自己更新ループ禁止ポリシー (Agent Memory Substrate)
- [Deployment](docs/deployment.md) — Caddy リバースプロキシを用いた production 配備
- [Contributing](CONTRIBUTING.md) — 開発セットアップ、コードスタイル、PR ワークフロー
- [Security](SECURITY.md) — 脆弱性報告、セキュリティ設計
- [Python SDK](https://github.com/kagura-ai/kagura-memory-python-sdk) — `KaguraClient`（MCP）に加え、リソース・ファイル・シークレット・ワークスペース・エージェント bootstrap の REST クライアントと、ドキュメント取り込みの `FileIngestor`
- **プロジェクトサイト**: [www.kagura-ai.com/ja](https://www.kagura-ai.com/ja/) — 概要、ユースケース、スタート手順

## コントリビューション

開発セットアップ、コードスタイル、PR ワークフローは [CONTRIBUTING.md](CONTRIBUTING.md) を参照。

## ライセンス

[Apache License 2.0](LICENSE)