# dsh-recall
🌏 [English](README.md) · 中文
**对话历史回忆插件 —— 给 DeepSeek Harness 的 agent 一座"记忆迷宫"**
[](https://www.npmjs.com/package/dsh-recall)
[](LICENSE)
[](package.json)
[](https://github.com/deepseek-ai/deepseek-harness)
[
> **AI 再也不会"忘记"你说的话了。**
[DeepSeek Harness](https://github.com/deepseek-ai/deepseek-harness) (DSH) 原生插件:给 agent 一座**记忆迷宫**——为你们的每一段对话筑起走廊与房间。它记得你们之间发生过的一切:一个决定、一条设定、一次讨论、一句随口提的需求。你问"我们上次说到哪了",它走进迷宫,把当时的对话**原样**带回,再像聊天一样自然融进回答——你甚至察觉不到它"想了一下"。
对话历史回忆 · 三层检索(字面 / 模糊 / 语义)· 完全本地离线 · 压缩免疫
- 运行中,只在角落里安静地亮起一束扫动的光:

- 完成时,不留痕迹:

## 适合谁使用
- **长会话的重度用户**——一场对话跨数天、几百轮,翻不到头
- **写作者 / RP / 酒馆玩家**——设定、伏笔、人物关系散落在几个月前的对话里
- **代码与文档维护者**——当时拍板的理由、踩过的坑,压缩后只剩一句摘要
- **任何说过"我们上次不是聊过吗"的人**——它把原话找回来,而不是让你重讲一遍
反过来:如果你的会话都很短、随时能翻,你大概用不上它——它专为"历史太长、记忆被压缩"的场景而生。
## 快速开始
```sh
dsh plugin --profile web add dsh-recall@0.2.2
```
**一条命令即可**:包自带组合补丁(bundle 层),插件与它所需的全文搜索会自动接线。重启 `dsh web` 即可。没有额外步骤:模型随包预置(完整版约 37MB),首次搜索自动建立索引,随后在后台安静完成语义预热(几分钟,对你的使用无感知)。
> 也可以在 [dsh-extension-hub](https://github.com/Relistencode/dsh-extension-hub) 的插件管理页 **「附加功能」** 区块里一键安装/停用/卸载本插件。
**从源码安装(git 克隆):**
```sh
dsh plugin --profile web add git+https://github.com/Relistencode/dsh-recall.git
```
仓库已跟踪模型文件(`models/model_merged.onnx`)与内置推理运行时:git 安装完全离线可用,**无构建步骤、无需 `allowBuilds` 配置**。可选依赖 `dsh-recall-models` 仍会尝试从 npm 拉取;拉取失败时自动改用仓库内模型——两种情形语义层都可用。所有路径经 `$DSH_HOME`(默认 `~/.dsh`)解析,harness 主目录在哪个位置安装效果完全一致。
### 可选配置
```yaml
- id: recall
name: dsh-recall
config:
semantic: false # 关闭语义层(只保留字面 + 模糊,包体更小)
warmup: gentle # 慢速预热,降低后台 CPU 占用(仅预热期间占用,后续使用 0 占用)
```
## 它不是什么
- ❌ **不是上下文工程** —— 不把全部历史硬塞进模型窗口
- ❌ **不是提示词工程** —— 不靠 prompt 让模型"装作记得"
- ❌ **不是 memory 文档系统** —— 不需要手动维护 MEMORY.md / 备忘录
- ✅ 是**真正的回忆能力**:按需检索对话**原始记录**——包括**已被压缩掉**的历史(压缩只是摘要,原文永远可搜)
## 能力概览
| 能力 | 实现 |
|---|---|
| 三层混合检索 | 字面 / 模糊 / 语义自动合并,覆盖率门控(≥90%)+ 静默降级链 |
| 渐进披露 | 默认轻量粗召回(标题 + 片段 + 事件,约 100–800 tokens);需要时 `detail` 下钻原文——命中窗口 / 精确原文 / 分页翻阅 |
| 事件聚合 | 同一主题的多次提及合并为事件(`[startSeq..endSeq]`,文本块间隔 ≤5)——一次拿到完整片段集,而非零散碎片;事件全文仍是一次 `detail` 下钻之遥 |
| 自动调用 | agent 自主在需要时回忆(压缩后、缺细节时主动调用),无需用户开口;用户也可主动要求 |
| 自动回忆层 | 用户消息到达时的宿主确定性门控(流程命令 / 回指词 + 模糊索引确认的旧片段)静默注入相关历史——无额外 LLM 调用、无 UI |
| 压缩锚点 | 监听 `compaction/summary`,压缩后自动注入一次轻量锚点(摘要 + 关键原文片段,3 轮过期) |
| 作用域控制 | 默认仅当前会话;`workspace` / `all` 只在用户明确要求时使用 |
| 压缩免疫 | 索引覆盖全量历史,含 shadowed(压缩遮蔽)事件 |
| 增量索引 | live 会话走 `ctx.sessions`,持久化走 `sessionPersistence`,append-only 增量 |
| 后台预热 | worker 线程嵌入(~10 条/秒),host 事件循环零阻塞 |
| 无感知 UI | 「回忆中…」光波 → 「回忆完成」一行,结果不进 UI、由 agent 自然呈现 |
| 完全本地离线 | 零 npm 运行时依赖;无外部模型 API;断网也能用 |
## 架构
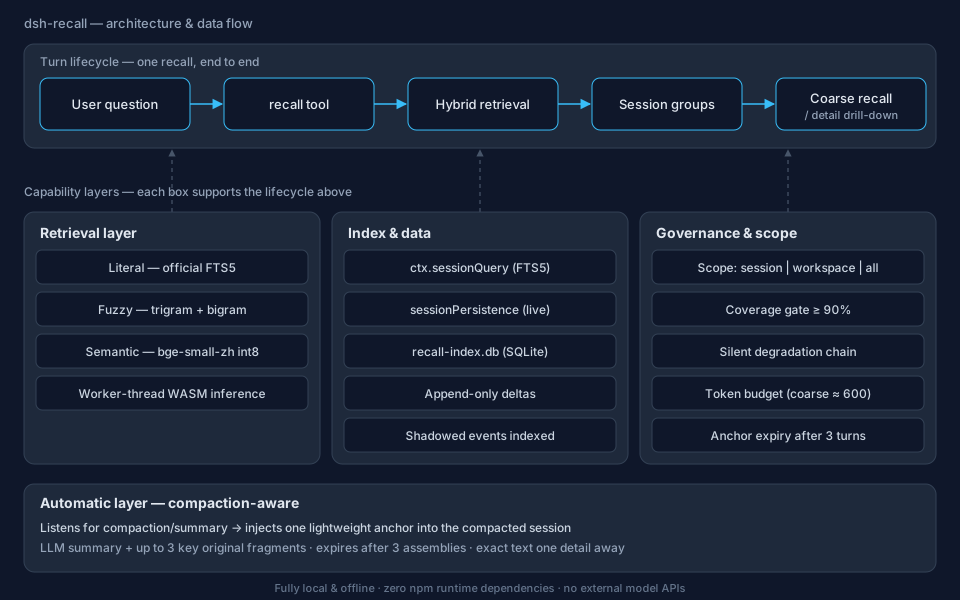 - **回合生命周期(顶部)**:一次回忆是一条直线——用户提问、agent 调用 `recall` 工具、三层检索、命中按会话聚合成事件、agent 按需拿到轻量粗召回或下钻窗口。
- **检索层**:三条独立的检索通道(字面 / 模糊 / 语义),在覆盖率门控下合并(见[三层混合检索](#三层混合检索))。
- **索引与数据**:全部走官方服务(`ctx.sessions` / `ctx.sessionPersistence` / `ctx.sessionQuery`)读取——不解析 .zstd、不碰私有格式。插件自有的 `recall-index.db`(SQLite)存放模糊索引、向量与 trigram FTS。
- **治理与作用域**:作用域红线(默认当前会话)、覆盖率门控、降级链、token 预算都在这一层。
- **自动层**:两条静默监听——`compaction/summary` 把每次压缩变成一条轻量锚点(历史被折叠后 agent 依然有方向感);自动回忆门控盯住用户消息,当用户提到更早的讨论时静默注入相关历史。
## 核心机制
### 三层混合检索
| 层 | 技术 | 解决 |
|---|---|---|
| 字面 | 官方 FTS5 全文索引 | 精确命中原词 |
| 模糊 | 自建 trigram + 字符二元组索引(零依赖) | 记不清原话、只记得片段、换字漏字 |
| 语义 | 本地 bge-small-zh 模型(int8,24MB 预置) | 换词、意译、"大概意思"也能想起来 |
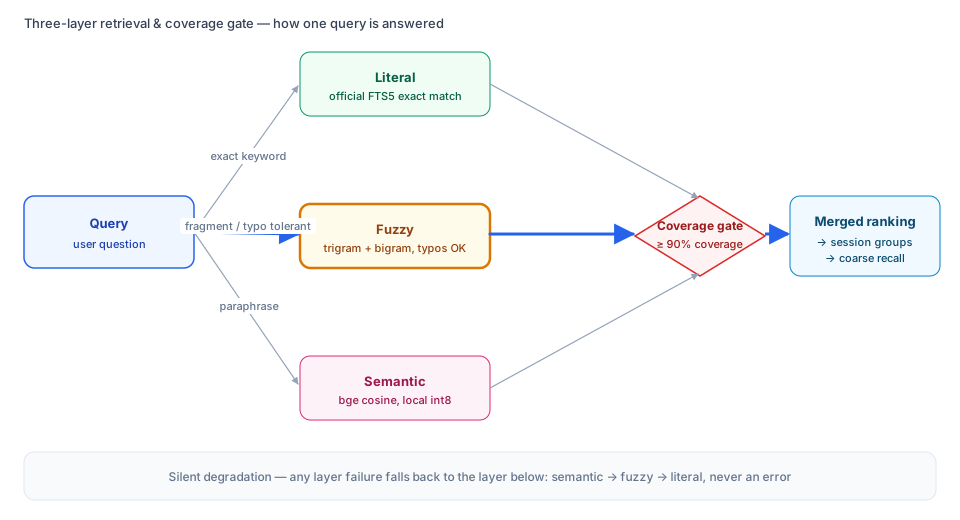 - 模糊层是**主路径**(它已覆盖字面层的能力且容错更强);官方 FTS5 是兜底;语义层**只在覆盖率 ≥90% 时才参与混合**——否则保持沉默,绝不让排序变差。
- 任一层失败都静默降级到下一层——语义 → 模糊 → 字面,永不报错。`recall` 永远有答案。
- 推理在 **worker 线程**运行(WASM 放主线程会阻塞 host 事件循环;实测 ~9.6 条/秒零阻塞)。
- 全部本地运行、完全离线——无外部模型 API、无网络。
### 渐进披露
回忆分两阶段,第二阶段只在 agent 真正需要时触发:
| 阶段 | agent 拿到什么 | 成本 |
|---|---|---|
| 1 — 粗召回(默认) | 会话标题 + 片段 + 同主题事件,分组排序 | 最多 10 个会话约 **100–800 tokens** |
| 2 — `detail` 下钻 | 会话命中列表 / 精确原文窗口(`readEvent`)/ 分页翻阅 | 约 **300 tokens/会话**(如 ±3 事件窗口) |
实机实测:粗召回比旧版全量上下文窗口**省 ~80% token**(10 会话命中:2500–3000 → ~600,聚合前)。事件聚合保持同样的纪律——只带片段,事件全文一次下钻之遥——粗召回单次仍在 ~800 tokens 以内。无关内容从不进上下文——而需要时,原文永远一次下钻之遥。
### 压缩锚点
压缩是记忆最容易丢失的地方——harness 生成摘要,原文被遮蔽。dsh-recall 监听 `compaction/summary`,立即为被压缩会话注入一条轻量锚点:
- **内容**:LLM 摘要 + 最多 3 条关键原文片段(优先用户消息,再取最长文本块)。
- **过期**:3 轮组装后自动消失——它是路标,不是拐杖。
- **逃生口**:精确原文随时 `detail` 下钻,永远可还原。
- 实机端到端验证:真实 `/compact` 后,锚点在下一轮组装中注入,内容正确,3 轮后自动过期。
### 自动回忆层
agent 自行决定何时调用 `recall`,但模型无法可靠判断「我是不是缺细节」——这一层补的正是这个缺口。每条用户消息到达时,宿主运行一个**本地确定性门控**(`lib/auto-gate.js`):
- **P——流程命令**(「继续」「我重启了」「runtime 恢复」):自动回忆上一轮话题——实测:占手动触发语境 56%,普通消息误报仅 3.6%。
- **A——回指词**(「之前说」「记得吗」「搜索历史」…)且其指代片段(当前轮**不可见**的字符二元组连续段)确实**命中模糊索引**——这个词真的在更早出现过,才放行。
门控命中后,一次轻量当前会话检索静默发生,命中以**不可见**方式注入 agent 系统提示(3 轮过期;会话恢复场景 1 轮;注入有效期内不重复触发=内置防抖)。agent 像一直知道那样作答——无感、无额外 LLM 调用、零网络。
门控基于真实手动触发语料校准(19 会话 / 18 语境,`scripts/analyze-triggers.mjs`):**P+(A∧B3≥0.6) 覆盖 89% 手动触发、误报 8.9%**(A|P 单独:100% 覆盖 / 18.9% 误报)。成本 ≈ 每轮平均 +190~400 tokens(触发率 9~19% × 3 轮 × ~700)。
### 作用域与隐私
- 默认作用域是**仅当前会话**——跨会话(`workspace`)、跨项目(`all`)只在用户明确要求时使用。
- 呈现层无感知:一声安静的「回忆中…」光波、一行「回忆完成」,别无其他。结果不进 UI——由 agent 自然呈现。
- 数据留在本机:无外部 API、无遥测、无网络。
## 实测数据
### token 收益(v0.2.1 实机)
| 指标 | 结果 |
|---|---|
| 粗召回成本(默认) | 每次调用约 100–800 tokens |
| 旧版全量上下文窗口(10 会话) | 约 2500–3000 tokens——**多花 3–4 倍** |
| `detail` ±3 窗口 | 约 300 tokens/会话 |
| 压缩锚点 | 实机验证:真实 `/compact` → 锚点下一轮注入,内容正确,3 轮自动过期 |
| 语义预热 | worker 线程 ~10 条/秒,host 事件循环零阻塞 |
### 检索质量(黄金评测集)
合成 4 会话语料(32 条文档)+ 23 条人工标注查询(精确 / 模糊错字 / 意译 / 跨会话),内存运行、真实模型——复现:`node eval/run-golden.mjs`:
| 变体 | recall@5 | MRR | nDCG@10 |
|---|---|---|---|
| 仅字面(模拟官方 FTS5) | 0.196 | 0.217 | 0.201 |
| 仅模糊 | 0.587 | 0.652 | 0.579 |
| 仅语义 | 0.533 | 0.609 | 0.529 |
| **混合(生产路径)** | **0.696** | **0.761** | **0.687** |
- 混合融合胜过任何单层(**比最佳单层 recall@5 高 +19%**)——三层各有贡献,没有装饰层。
- 字面层单独最弱(仅精确匹配;unicode61 分词对中文不分词)——印证其兜底定位。
- 模糊层是主路径(胜过语义单层);语义层在意译、换词查询上补召回。
- **覆盖率门控验证**:半预热时门控正确回退为仅模糊(0.587 = 纯模糊);强行使用半热语义层在小语料上有小幅增益(0.674)——0.90 门控是为真实长会话保留的保守安全默认,未针对本集调参。
- 已知漏检(已声明的边界):低于语义阈值且无字面重合的完全换词(如"打码" 找 "脱敏")、抽象概念查询(如"方案")。
## 更新记录
更新记录(点击展开)
> npm 首个发布版本为 **0.1.0**;以下 0.0.x 为开发里程碑。
- **2026-08** — v0.3.0:**宿主自动回忆层**——用户消息的本地确定性门控(P:流程命令「继续/重启/restore」;A:回指词 + 「旧内容片段命中模糊索引」确认)把相关历史静默注入系统提示(3 轮;恢复 1 轮;注入有效期内防抖不重触发)。基于真实手动触发语料校准(19 会话 / 18 语境:P 56% @3.6% FP;P+(A∧B3≥0.6) 89% @8.9%;A|P 100% @18.9%);离线研究脚本 `scripts/analyze-triggers.mjs`;索引安全修复——语料不可见保护(空 live+persisted 语料不再被当作"全部会话已移除")、移除/重建时连带清理向量。
- **2026-08** — **结果聚合**:同一主题的多次提及合并为完整事件(`[startSeq..endSeq]`,文本块间隔 ≤5;阈值基于真实索引实测——p50 同主题间隔 3、61% ≤5)。粗召回每会话最多返回 3 个事件,token 纪律不变(只带片段;事件全文仍是一次 `detail` 下钻之遥)。**v2 路线图全部完成。**
- **2026-08** — 检索质量评测:黄金集(4 会话 / 32 文档 / 23 条人工标注查询)实测生产混合路径 recall@5 **0.696** / MRR **0.761** / nDCG@10 **0.687**——比最佳单层高 **+19%**。消融确认模糊层为主路径、字面层为兜底;覆盖率门控实机验证(半预热正确回退为仅模糊)。复现:`node eval/run-golden.mjs`。
- **2026-08** — v0.2.1 实机实测:粗召回约 **100–600 tokens**,旧版全量上下文窗口 10 会话命中约 **2500–3000 tokens**(省 ~80%);`detail` ±3 原文窗口约 300 tokens/会话。压缩锚点端到端验证:真实 `/compact` 后,LLM 摘要 + 3 条关键原文片段在下一轮组装中自动注入,3 轮后自动过期。
- **2026-08** — v0.2.1:修复——detail 原文窗口正确提取 assistant/message 的文本块(块数组)并按块类型过滤,助手回复的精确原文在下钻结果中完整可见(实机验证中发现)。
- **2026-08** — v0.2.0:**渐进披露 + 手动/自动双模式**——`recall` 默认轻量粗召回(标题+片段,token 大降),新增 `detail` 参数下钻原文(会话命中列表 / 精确原文窗口 / 分页翻阅);description 重写:agent 自主调用(压缩后、缺细节时主动回忆,无需用户开口),scope 红线与无感知呈现保留;**压缩锚点**——压缩后自动注入一次轻量锚点(LLM 摘要 + 关键原文片段,3 轮过期),细节随时可下钻。
- **2026-08** — v0.1.0:正式发布——**一条命令安装**(`dsh.bundle.patch` 自动接线插件行并启用全文搜索);23.9MB 语义模型拆为可选包 `dsh-recall-models`(`--omit=optional` 即轻量版);双语 README + 多语言 UI。
- **2026-08** — v0.0.6:语义层——本地 bge-small-zh(int8,随包预置,完全离线)跑在 worker 线程;字面/模糊/语义**三层混合检索**,覆盖率 ≥90% 门控 + 静默降级;后台预热(~10 条/秒,host 事件循环零阻塞)。
- **2026-08** — v0.0.4:模糊检索——自建 trigram + 字符二元组索引(零 npm 依赖):只记得片段、记不清原话、换字漏字也能找到。
- **2026-08** — v0.0.2:`recall` 工具——官方 FTS5 全文检索全部历史会话(含压缩掉的历史),按会话聚合 + 上下文窗口;作用域控制(默认仅当前会话);无感知 UI(回忆中… / 回忆完成)。
## Roadmap
**v1 · 完成** — 三层混合检索:官方 FTS5 字面 / 自建 trigram+bigram 模糊 / 本地 bge embedding 语义;覆盖率门控、后台预热、静默降级链。
**v2 · 检索控制**
- [x] **两阶段召回(browse/detail 下钻)**:默认轻量粗召回(标题 + 摘要,约 100–800 tokens),agent 选定会话后按需精读完整上下文——无用信息不进上下文
- [x] **压缩锚点**:监听 `compaction/summary`,压缩后自动注入一次轻量锚点(摘要 + 关键原文片段),原文随时可下钻还原
- [x] **自动调用**:agent 自主在需要时调用(压缩后、缺细节时),无需用户开口;用户也可主动要求
- [x] **宿主自动回忆层**:用户消息确定性门控(流程命令 / 回指词 + 模糊索引确认的旧片段)静默注入相关历史——无需用户开口(v0.3.0)
- [x] **结果聚合**:同一主题的多次提及合并为完整"事件"——文本块间隔 ≤5 的连续命中归并为 `[startSeq..endSeq]` 事件(阈值基于真实索引实测:p50 同主题间隔 3,61% ≤5);事件全文仍是一次 `detail` 下钻之遥
**v3 · 记忆组织**
- **主题聚类**:embedding 相似度聚类,按话题归拢呈现
- **记忆沉淀**:跨会话提炼设定/决策条目,沉淀为长期记忆
- 远期:评估主题化 / 分层压缩机制——只评估,不改 DSH 核心
## 已知边界
- 短查询(≤4 字)的语义补位较弱(bge 短文本余弦区分度有限),由模糊层 LIKE 兜底
- 语义排序对完全无字面重合的查询不完全可靠——模糊层始终是主路径,agent 最终判断
- 模型为 int8 量化,语义质量为"够用"级别;可换 fp32 模型(约 4 倍体积)追求极致
## 开发与测试
```sh
node .smoke-recall.mjs # 单元 + 集成(mock,无需模型)—— 90+ 断言
node .smoke-semantic.mjs # 真模型集成(需 models/ 就位)
```
覆盖:tokenizer 对拍(与 transformers.js 逐 token 一致)、索引增量、作用域、混合排序、降级、预热、事件聚合。
### 模块
| 文件 | 职责 |
|---|---|
| `lib/index.js` | 工具注册、作用域解析、混合排序、会话与事件聚合、预热调度 |
| `lib/fuzzy-index.js` | 自建 SQLite 索引(trigram FTS + bigram + 向量表),零 npm 依赖 |
| `lib/tokenizer.js` | BERT WordPiece 分词器(纯 JS,与官方实现逐 token 对拍一致) |
| `lib/semantic.js` | Embedder:worker 线程、批量嵌入、懒加载 |
| `lib/embed-worker.js` | worker 内 WASM 推理 + mask-aware mean pooling + L2 归一 |
| `lib/vendor/` | vendored onnxruntime-web(入口 0.8MB + wasm 12MB)+ tokenizer.json |
| `models/` | 合并单文件 int8 模型(23MB,发布时拆为 optional 包) |
| `lib/client.js` | 极简 ToolView(「回忆中…」/「回忆完成」,zh/en 随用户语言) |
### 发布结构
- `dsh-recall` —— 主包(代码 + vendor 运行时 + tokenizer)
- `dsh-recall-models` —— optional 依赖(23MB 模型),npm 默认安装;`--omit=optional` 即轻量版,缺失自动降级
## 参考与致谢
- 官方:`@deepseek-ai/dsh-session-query(-sqlite)`、`dsh-tools`、`dsh-session-persistence`
- 模型:BAAI/bge-small-zh-v1.5 (MIT) · onnx-community int8 导出 · onnxruntime-web (MIT)
- 生态参考:[dsh-plugin-recall](https://github.com/truelove-dreamer/dsh-plugin-recall)(一期同构的官方 FTS 检索工具)、[dsh-mneme](https://github.com/modusensus/dsh-mneme)(本地语义记忆,混合召回降级链思路)
## License
MIT