<div align="center">

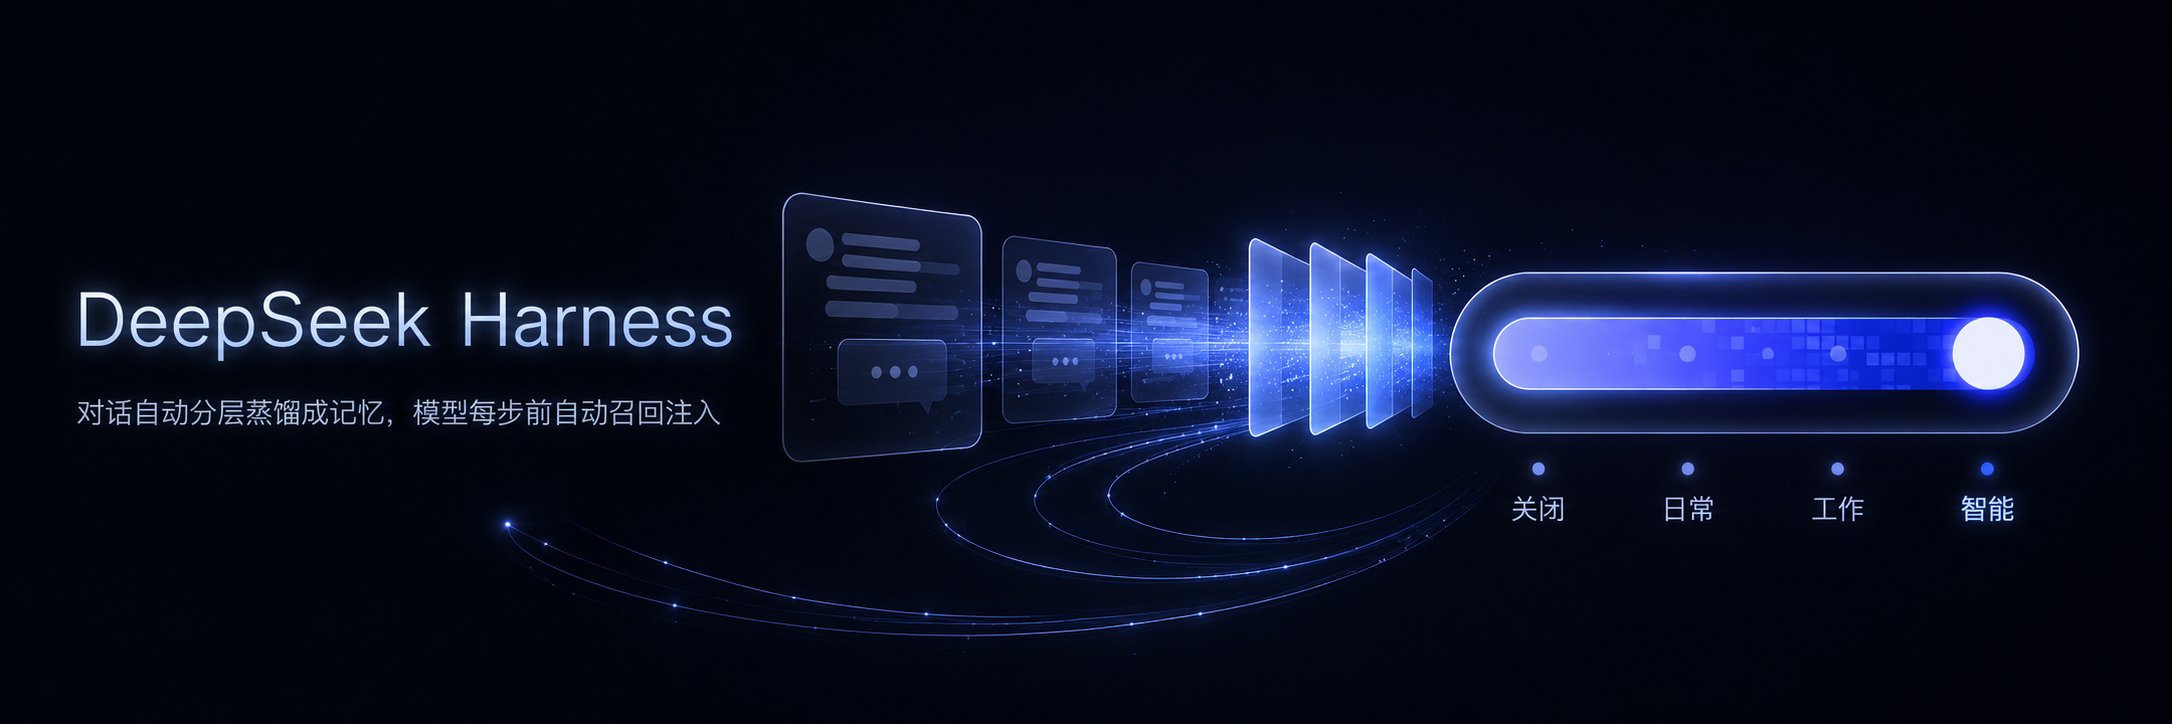
<img src="./assets/img/Hero.png" width="100%"
alt="Banner hero di DeepSeek Harness: le conversazioni vengono distillate automaticamente in memorie stratificate e richiamate prima di ogni passo del modello — a destra le bolle di chat si dissolvono strato dopo strato in tre fasce di luce progressivamente più brillanti che alimentano una capsula di vetro con sfera luminosa e orbita sfumata (tacche 日常·工作·智能·关闭, quattro livelli); i fili di luce che ritornano suggeriscono l'iniezione del richiamo">

# dsh-prime-memory

**Plugin di memoria a distillazione stratificata per DeepSeek Harness: la conversazione viene elaborata in background — cattura L0 → memorie atomiche L1 → consolidamento delle scene L2 → distillazione del profilo L3 — e prima di ogni passo del modello le memorie rilevanti vengono iniettate automaticamente nel contesto.**

[English](README.en.md) · [中文](README.md) · [Ultima release](https://github.com/drscrewdriver/dsh-prime-memory/releases/latest) · [Segnala un problema](https://github.com/drscrewdriver/dsh-prime-memory/issues)

[![npm version](https://img.shields.io/npm/v/dsh-prime-memory?color=6f83ff\&style=flat-square\&label=npm)](https://www.npmjs.com/package/dsh-prime-memory)
[![DSH 0.2.0-rc.1](https://img.shields.io/badge/DSH-0.2.0--rc.1-8b5cf6?style=flat-square)](https://github.com/deepseek-ai/deepseek-harness)
[![MIT License](https://img.shields.io/badge/license-MIT-536990?style=flat-square)](LICENSE)

</div>

<details open>
<summary>🌐 Lingua / Language</summary>

- [中文 README](./README.md)
- [English README](./README.en.md)
- [日本語 README](./README.ja.md)
- [한국어 README](./README.ko.md)
- [README in italiano](./README.it.md)
- [README en français](./README.fr.md)
- [README auf Deutsch](./README.de.md)
- [README на русском](./README.ru.md)
- [README en español](./README.es.md)
- [安装指南（中文）](./INSTALL.md)
- [Installation guide (English)](./INSTALL.en.md)
- [日本語インストールガイド](./INSTALL.ja.md)
- [한국어 설치 안내](./INSTALL.ko.md)
- [Guida all'installazione (Italiano)](./INSTALL.it.md)
- [Guide d'installation (français)](./INSTALL.fr.md)
- [Installationsanleitung (Deutsch)](./INSTALL.de.md)
- [Руководство по установке (Русский)](./INSTALL.ru.md)
- [Guía de instalación (Español)](./INSTALL.es.md)
- [更新日志（中文）](./CHANGELOG.md)
- [Changelog (English)](./CHANGELOG.en.md)
- [日本語 changelog](./CHANGELOG.ja.md)
- [한국어 changelog](./CHANGELOG.ko.md)
- [Changelog in italiano](./CHANGELOG.it.md)
- [Changelog en français](./CHANGELOG.fr.md)
- [Changelog auf Deutsch](./CHANGELOG.de.md)
- [Changelog на русском](./CHANGELOG.ru.md)
- [Changelog en español](./CHANGELOG.es.md)

</details>

## Matrice di compatibilità delle versioni DSH

| Versione DSH | API di registrazione delle impostazioni | Stato |
|---|---|---|
| 0.1.1-rc.2 | `settings.register()` (scope live) | ✅ Verificato |
| 0.1.2-rc.1 | `settings.register()` (fallback disponibile) | ⚠️ Dedotto dalla documentazione del framework, non provato sul campo |
| 0.1.3-rc.1 | `settings.register()` (fallback disponibile) | ⚠️ Non provato sul campo (dalla 0.1.3 i namespace sono semplici stringhe; il plugin è compatibile) |
| 0.1.5-rc.2 | `settings.register()` (fallback disponibile) | ⚠️ Non provato sul campo; semantica della superficie Session V3 e slot barra di input/impostazioni in attesa di regressione |
| 0.2.0-rc.1 | `settings.register()` (scope live) | ✅ Linea di adattamento in corso (ricablaggio dell'evento agent/session-start → agent/created) |

> Meccanismo di compatibilità: la registrazione delle impostazioni passa per tre rami a runtime
> (`register` → ponte `installSection` → degrado a sempre-attivo),
> vedi la voce 0.11.0 del [CHANGELOG.md](./CHANGELOG.md). `dsh.plugin.json` dichiara
> `engines.dsh` 为逐 rc 精确枚举串（0.1.0-rc.2 → 0.2.1-rc.5，20 rc）.

## Avvio rapido

Richiede Node ≥ 22.16. Due stili di invocazione a scelta (il prefisso `npx` può sostituire `dsh` in qualunque comando qui sotto):

```bash
# Modo 1: eseguire la CLI ufficiale direttamente con npx (niente dsh preinstallato; versione fissabile, es. dsh-prime-memory@0.8.4)
npx -y @deepseek-ai/dsh plugin --profile web add dsh-prime-memory

# Modo 2: CLI dsh già installata (dsh è un inoltratore pnpm; se pnpm manca, prima npm i -g pnpm)
dsh plugin --profile web add dsh-prime-memory

# Sorgenti alternative del pacchetto: repository GitHub / percorso locale (sviluppo/debug; link: punta al repository, bastano npm run build + riavvio di dsh)
dsh plugin --profile web add https://github.com/drscrewdriver/dsh-prime-memory
dsh plugin --profile web add /path/to/dsh-prime-memory
```

### Far installare dall'agente (consigliato)

Se l'agente attuale può eseguire comandi da terminale, inviagli per intero il messaggio seguente:

```text
Installa il plugin dsh-prime-memory per il profilo web di DeepSeek Harness.

Esegui solo i due comandi seguenti e non modificare altri profili:
dsh plugin --profile web add dsh-prime-memory
dsh --profile web --dump-config

Quando dsh-prime-memory compare nell'output, comunicami l'esito dell'installazione.
Non chiudere o riavviare di tua iniziativa il DSH in esecuzione; a installazione completata, ricordami di riavviare manualmente il DSH Web Host.
```

L'agente deve restituire l'esito dell'installazione e dirti esplicitamente se
`dsh-prime-memory` è comparso nella configurazione.

Questo pacchetto dichiara un livello di composizione `dsh.bundle` (`cordis.patch.yml`); dopo l'installazione
**la riga del plugin viene montata automaticamente** — non serve ritoccare a mano
`$DSH_HOME/profiles/web/cordis.patch.yml`. Poi riavvia DeepSeek Harness e verifica: la comparsa
delle directory `conversations/ records/ scenes/` e di `memory.db` sotto
`~/.dsh/memory/` sancisce l'applicazione riuscita del plugin; la pagina «Memoria» nelle impostazioni
e il pill di modalità nella barra di input sanciscono la metà client pronta.

**Disinstallazione**: `dsh plugin --profile web remove dsh-prime-memory` + riavvio. I dati restano in
`~/.dsh/memory/`; se non servono più, elimina a mano l'intera directory.

### Sviluppo dai sorgenti

```bash
git clone https://github.com/drscrewdriver/dsh-prime-memory
cd dsh-prime-memory
npm install && npm run build
dsh plugin --profile web add .        # installazione link: ; dopo le modifiche al codice bastano npm run build + riavvio di dsh
npm run smoke                         # smoke test (ricompilare prima: vedi comando sotto)
npx tsc src/smoke.ts --outDir dist-smoke --module nodenext --moduleResolution nodenext --target es2022 --strict --skipLibCheck --esModuleInterop
```

## Flusso dei dati a runtime

<p align="center">
  <img src="./assets/readme/flow.svg" width="100%"
       alt="Flusso dei dati a runtime di dsh-prime-memory: a sinistra gli eventi di conversazione di User e Assistant affluiscono al plugin (cattura L0, distillazione L1–L3, richiamo, strumenti di memoria), il plugin inietta le memorie rilevanti nel nucleo DSH a destra via agent/pre-step; la distillazione riutilizza il ctx.llm del nucleo, i dati sono scritti in doppio in ~/.dsh/memory/">
</p>

Il plugin si aggancia agli eventi nativi di dsh (`session/event` per la cattura, `agent/pre-step` per l'iniezione); le chiamate di distillazione riutilizzano il `ctx.llm` dell'host. Il richiamo si presenta come **iniezione lato messaggi**: le memorie rilevanti arrivano come un messaggio sintetico piazzato prima del nuovo messaggio dell'utente, mostrato nel flusso come una riga \*\*«Iniezione di contesto · memory»\*\* (cliccando si vedono i contenuti intercettati) — l'utente vede con i propri occhi che «la memoria agisce». L'iniezione è soggetta a un budget di lunghezza e a uno di tempo; al superamento si tronca o si salta, mai a costo di rallentare la conversazione. **Deduplica intra-sessione**: una memoria già iniettata non lo viene una seconda volta (è già nel contesto del modello: si risparmiano token quando l'utente torna sul medesimo tema); quando il contesto viene compresso con `/compact` o svuotato il registro si azzera e la memoria può essere reiniettata; una memoria aggiornata (id nuovo quando cambia il contenuto) non resta penalizzata dalla vecchia soppressione. **Ponderazione di freschezza**: l'ordinamento del richiamo applica una ponderazione morbida `rilevanza × max(0.5, 0.5^(giorni dall'ultimo aggiornamento/30))` — tra candidati di rilevanza simile passano prima le memorie fresche (i posti ruotano naturalmente), mentre una memoria datata ma sufficientemente rilevante viene richiamata come al solito (il pavimento limita la perdita a metà del punteggio di ordinamento al massimo: i fatti di lungo periodo non affondano); `recall.decayHalfLifeDays` è regolabile, 0 = disattivato.

**Cruscotto dei costi**: il costo in token di ogni chiamata LLM di distillazione (estrazione/deduplica/L2/L3) viene registrato per `provider/model` in una tabella di dettaglio SQLite (conservazione configurabile, 365 giorni predefiniti, pulizia scorrevole in scrittura; se la contabilità fallisce si limita ad avvisare e non blocca mai la distillazione); pagina impostazioni → Memoria → scheda **Costi** per visualizzare: linee di tendenza colorate per modello (granularità giorno/settimana/mese + finestra ultimi N giorni + filtro per livello L1/L2/L3), tabella livello × finestra temporale (chiamate / token di output e di ragionamento / media / mediana), cumuli per modello — il costo della distillazione a colpo d'occhio. Gli input si contano in caratteri (l'usage in streaming di dsh non include i token di input); output e ragionamento si contano in token.

**Strumenti di memoria (3):**

- memory\_search

- conversation\_search

- memory\_read\_scene

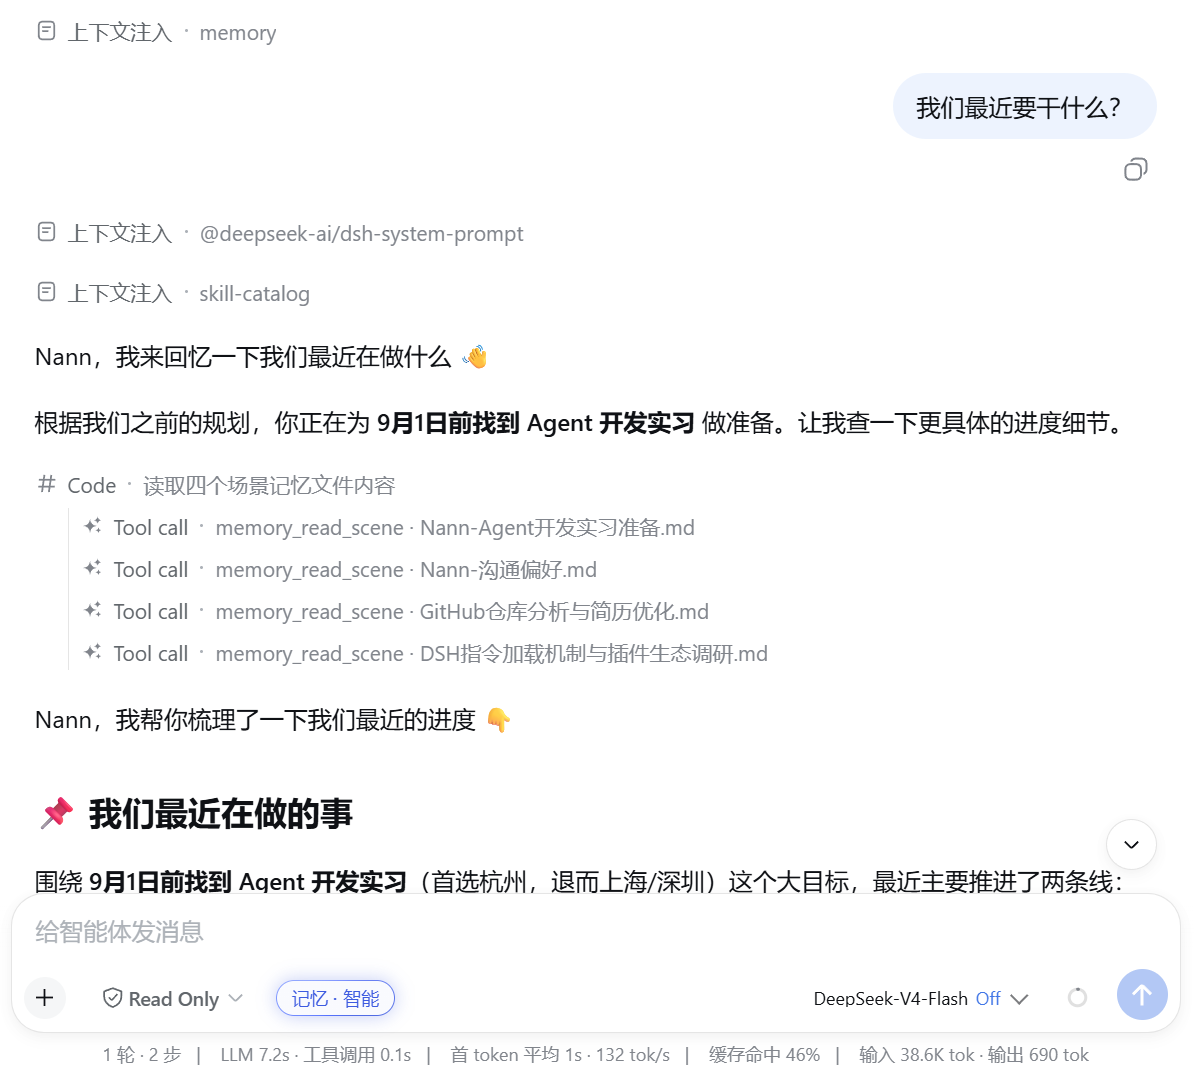
Registrazione reale su macchina — l'aspetto del richiamo iniettato e delle chiamate di strumento nella conversazione: la riga «Iniezione di contesto · memory» porta prima su le memorie rilevanti, poi il modello legge all'occorrenza il blocco di scena con `memory_read_scene` e risponde direttamente a memoria:

<p align="center">
  <img src="./assets/img/MemoryTools.png" width="60%"
       alt="Registrazione reale dell'interfaccia di chat (tema chiaro): sopra il messaggio utente «Cosa dobbiamo fare prossimamente?» si vede la riga «Iniezione di contesto · memory»; prima di rispondere l'assistente elenca 4 chiamate allo strumento memory_read_scene (parametri: nomi di file .md dei blocchi di scena), poi riepiloga a memoria gli obiettivi recenti e la roadmap">
</p>

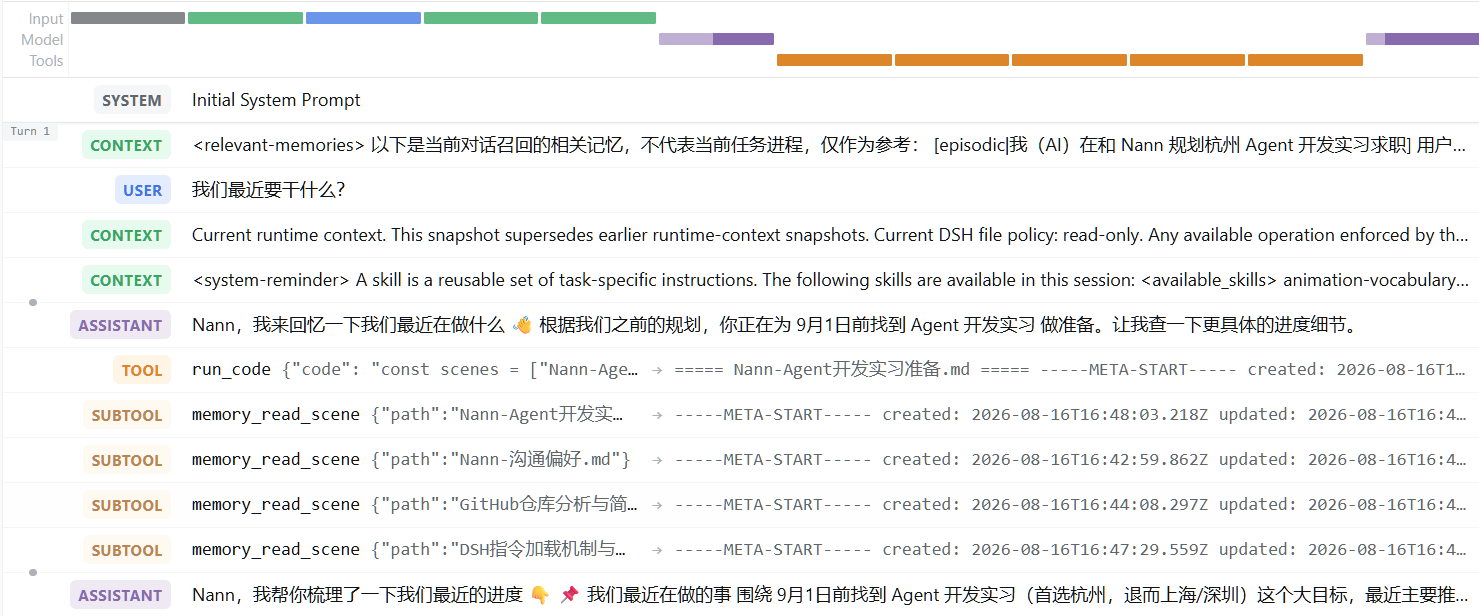
In una sessione ristretta in cui è aperta solo la via di esecuzione del codice, il modello chiama indirettamente gli strumenti di memoria tramite `run_code` (annidamento SUBTOOL nella vista delle traiettorie):

<p align="center">
  <img src="./assets/img/ToolTrajectory.png" width="80%"
       alt="Vista di traiettoria delle chiamate di strumento: cronologia colorata in alto e lista di passi a sinistra (etichette colorate SYSTEM/CONTEXT/USER/ASSISTANT/TOOL/SUBTOOL), nel passo dello strumento run_code sono annidate 5 chiamate del sotto-strumento memory_read_scene (marchio SUBTOOL), a destra il pannello di dettaglio del passo selezionato">
</p>

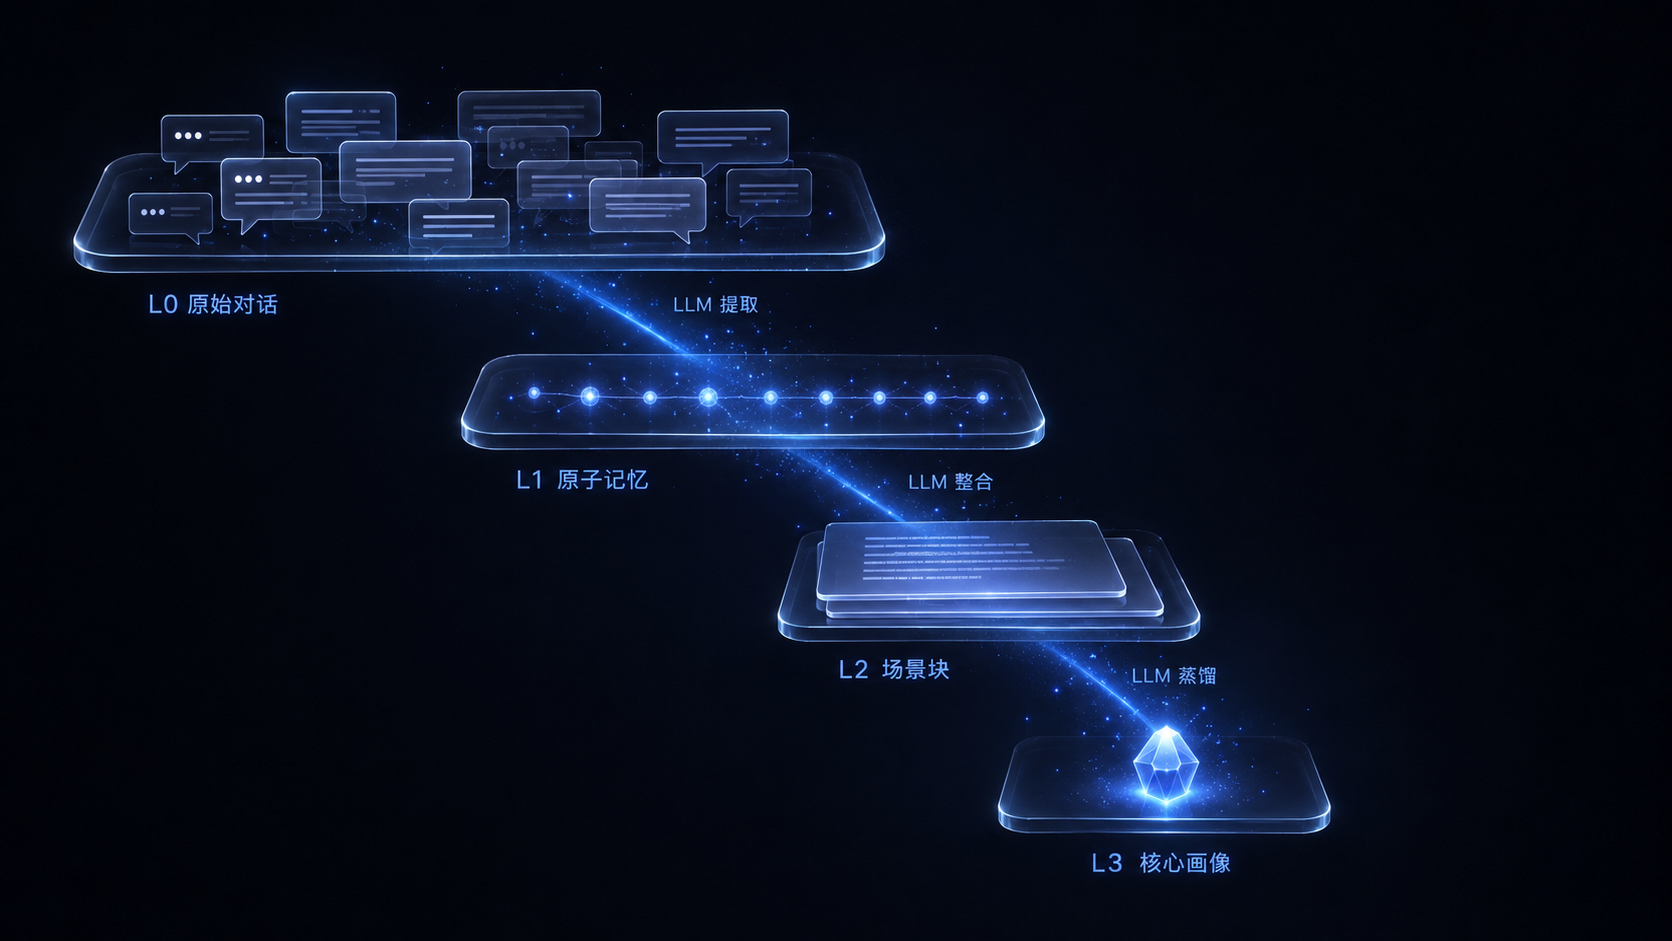
## Memoria stratificata (L0–L3)

<p align="center">
  <img src="./assets/img/Layers.png" width="100%"
       alt="Le quattro stratificazioni della memoria stratificata (raffinatezza crescente strato dopo strato, dall'alto a sinistra al basso a destra): L0 conversazioni grezze (bolle di dialogo) → L1 memorie atomiche (particelle di fatti luminose) → L2 blocchi di scena (lavagne documentali di vetro) → L3 profilo centrale (nucleo cristallino luminoso); gli strati sono collegati da fasci LLM di estrazione/consolidamento/distillazione, la larghezza decrescente indica la raffinazione progressiva dei dati">
</p>

## Modalità di memoria per sessione

<p align="center">
  <img src="./assets/img/Modes.png" width="100%"
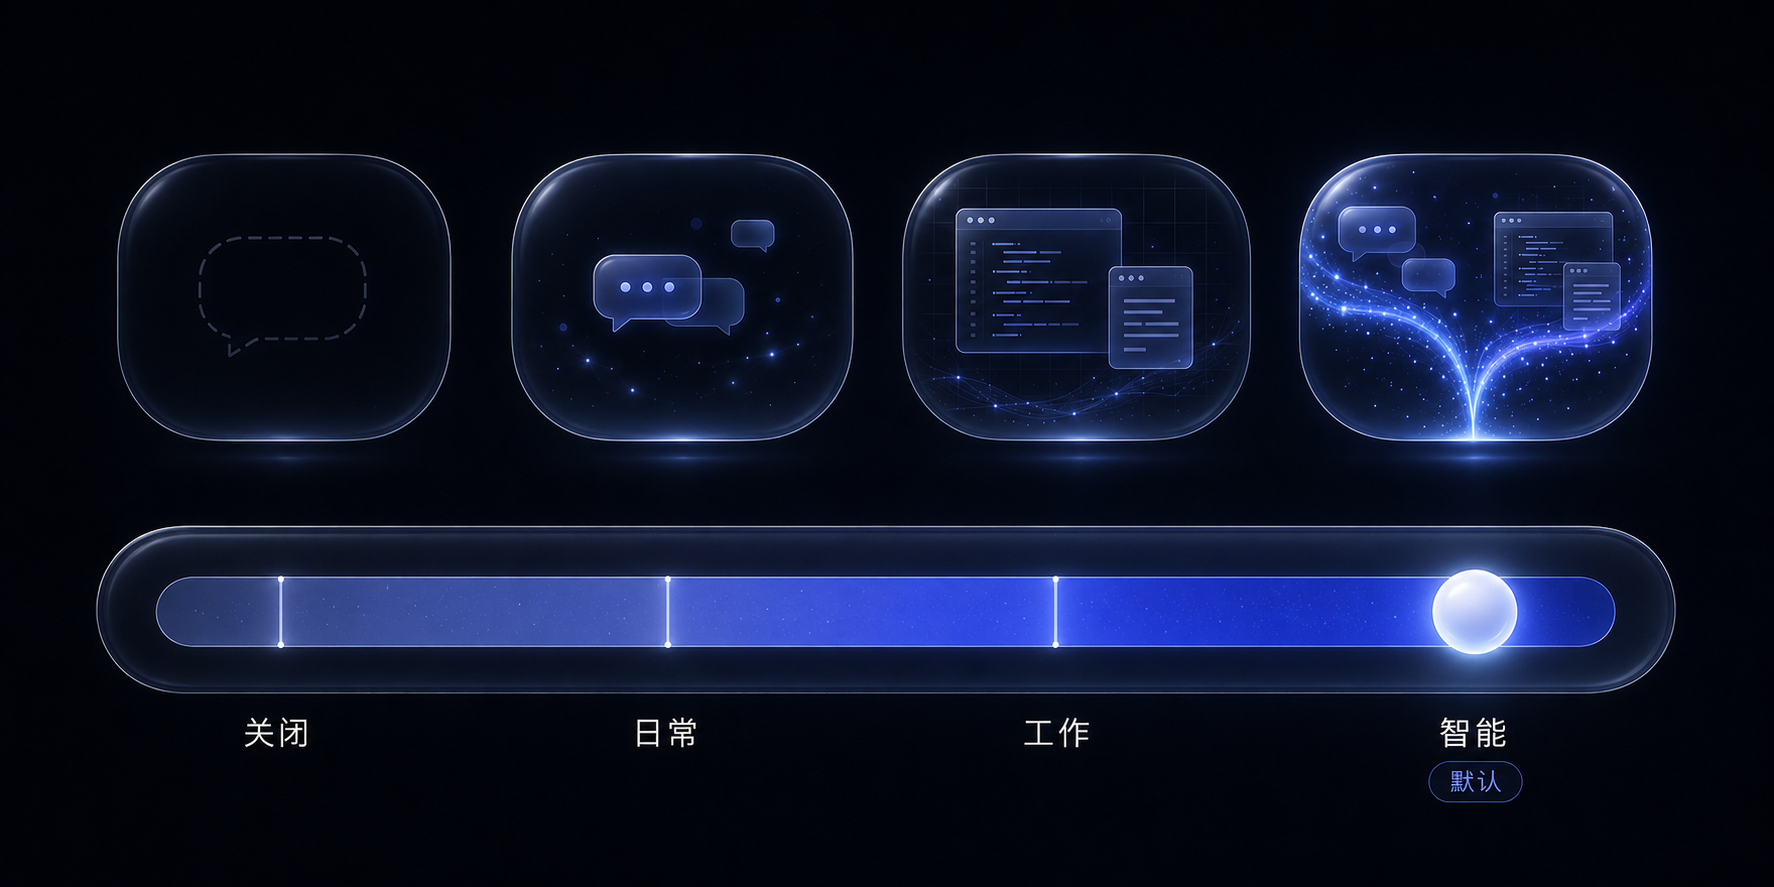
       alt="Modalità di memoria per sessione: una guida a capsula di vetro con quattro soste (日常·工作·智能·关闭 / Quotidiano·Lavoro·Intelligente·Spento), la sfera luminosa ferma su Intelligente (predefinito); sopra ciascuna modalità una micro-scena — Quotidiano: bolla di chat personale, Lavoro: pannello di documento di codice, Intelligente: due flussi che confluiscono al massimo della luce, Spento: bolla fantasma tratteggiata e sbiadita">
</p>

- **Il controllo**: un pill nella barra di input, a destra del selettore di modalità (`Memoria · auto`); un clic fa emergere sopra il cursore delle modalità, adattato ai temi chiaro/scuro;

- la metà inferiore del pannello flottante è l'**area informazioni di sessione**: esiti del richiamo (intercettamenti/turni di ricerca e cumulo), progresso di accumulo
  (fetta x della sessione / soglia efficace; in modalità Spento appare il numero di fette in sospeso), memorie prodotte nella sessione, numero di messaggi della sessione,
  più una riga di stato anomalo (archiviazione degradata / ricerca vettoriale non disponibile) e un riepilogo globale (voci in attesa di distillazione, ultima distillazione);
  i dati passano per l'endpoint `dsh-memory/session-stats` (registro puramente in memoria + COUNT indicizzato, zero I/O su file),
  con polling adattivo durante l'apertura (2 s se occupato / 5 s a riposo); alla chiusura si ferma;

- la scelta di ogni sessione è persistita per sessionId in `session-modes.json`: niente si perde al riavvio o alla ripresa;
  si somma all'interruttore globale (il globale è il rubinetto principale); L2/L3 sono interamente classificati per famiglia, i contenuti non trapelano.

- **Solo scrittura, nessuna lettura (#38)**: interruttore a tre stati «Iniezione» nel pannello flottante (segui il globale / on / off) — su «off» la sessione passa **in sola scrittura**: cattura e distillazione proseguono (la conversazione sedimenta regolarmente come L0→L1→L2/L3), ma in questa sessione non viene iniettata alcuna memoria
  (iniezione del richiamo, zone stabili profilo/navigazione e guida degli strumenti si fermano insieme; gli strumenti di lettura come `memory_search` rispondono con un avviso di sola scrittura). La faccia del pill diventa `Memoria · sola scrittura` a indicare lo stato; la preferenza è persistita per sessione: tornare a
  «segui il globale» la cancella e segue di nuovo l'interruttore di richiamo della pagina impostazioni; ideale per sessioni di debug/valutazione/sensibili che vogliano «assorbire senza disturbare».
  Ortogonale alla modalità Spento: Spento resta l'invisibilità totale (spenta persino la cattura), la sola scrittura conserva l'ingresso e chiude l'uscita.

## Anteprima dell'interfaccia

<p align="center">
  <img src="./assets/img/ui-dark.jpg" width="49.5%"
       alt="Panoramica del browser di memoria della pagina impostazioni a tema scuro: scheda di stato (versione del plugin, stato degli interruttori cattura/distillazione/richiamo, capacità FTS e vettoriali, conteggio memorie L1, modello di distillazione) e tessere statistiche, controlli dal tocco vetrato e accento blu freddo">
  <img src="./assets/img/ui-light.jpg" width="49.5%"
       alt="Il medesimo browser di memoria della pagina impostazioni a tema chiaro: stessa disposizione e stesse informazioni, fondo schede chiaro e medesima gamma di accenti, cambio tema senza ricaricare">
</p>

## Confronto misurato (DSH-MemBench: benchmark automatizzato)

Che «aspetto hanno» le risposte lo mostrano le immagini; questa sezione risponde con i numeri misurati di un **benchmark automatizzato** alla domanda «**a cosa serve davvero una volta attivato**» ([`bench/`](./bench/), riproducibile con un comando). Metodo: stessa libreria di scene, input identici alla virgola, **gruppo A (memoria attiva) eseguito 3 volte con valori accorpati, gruppo B (memoria spenta) eseguito 1 volta** (i task lunghi senza memoria inghiottono per scena più token; per questo il parafulmine di costo); la pista dialogo fa girare solo il gruppo A (le sessioni del gruppo B sono indipendenti e senza memoria: il fallimento è garantito, il confronto non dice nulla ed è stato ritirato). Ambiente della pista dialogo: `deepseek-v4-flash` ufficiale DeepSeek, plugin 0.8.5 (giudice e testato della stessa ceppaia, risposte integrali archiviate per verifica umana), Windows; la schematizzazione dei quesiti si ispira a [LongMemEval](https://github.com/xiaowu0162/longmemeval) / [LoCoMo](https://snap-research.github.io/locomo/) / [AMB](https://github.com/vectorize-io/agent-memory-benchmark), i tipi estesi e la pista ciclo di vita a [MemoryAgentBench](https://arxiv.org/abs/2507.05257) / [GoodAI LTM](https://github.com/GoodAI/goodai-ltm-benchmark) / BEAM.

> La pista dialogo costituisce la **nuova base 0.8.5** (plugin corretto + criterio di valutazione rettificato); i numeri della pista workflow restano l'archivio 0.8.3 (dal 0.8.5 la libreria di scene sale a 8, con una nuova scena di memoria prospettica; nuova esecuzione da fare).

### Pista dialogo (20 scene × 10 tipi di quesito × 3 passaggi = 420 domande): risponde con precisione?

> Base 0.8.5 (dati del gruppo A; il gruppo B della pista dialogo è ritirato, gira solo A).

<p align="center">
  <img src="./assets/readme/bench-dialog.svg" width="100%"
       alt="Grafico di accuratezza della pista dialogo di DSH-MemBench (gruppo A · memoria attiva): accuratezza complessiva 95,2% (400/420); i sei tipi centrali da 60 domande ciascuno — estrazione 58/60, multi-salto 60/60, cronologia 56/60, aggiornamento 55/60, ricordo di scena 52/60, rifiuto di rispondere 60/60 e 0 invenzioni; i quattro tipi estesi da 15 domande ciascuno — accumulo incrementale 15/15, aggiornamenti a catena 15/15, ordinamento di eventi 14/15, riformulazione sinonimica 15/15">
</p>

**Doppio canale di richiamo** (gruppo A): tasso di richiamo dell'iniezione passiva **78,1%** (i punti chiave della domanda compaiono nell'iniezione, 281/360); per il resto il modello **interroga da sé gli strumenti di memoria** — 106 domande con query attiva, **75 domande salvate dagli strumenti**; il 95,2% end-to-end è il risultato della sintesi dei due canali più lo sfruttamento del modello. Mentre la base di memorie si accumulava da scena a scena, le iniezioni di richiamo delle sonde hanno mescolato 295 volte memorie di altre scene (contate onestamente) e l'accuratezza complessiva è comunque salita dal 92,8% del primo al 97,7% dell'ultimo segmento — la resistenza alle interferenze ha retto davanti a una base gonfiata (offline, aggiungendo altri 600 record di rumore sintetico, il recall\@5 dello strato di ricerca cala solo di 2,8 pp).

**I punti deboli visti per strati**: indicatori offline dello strato di ricerca (recall\@5, riproduzione controllata) 73,3% complessivi, di cui ordinamento di eventi 0% e ricordo di scena 50% — il 93%+ end-to-end si deve alla robustezza del modello una volta iniettate le memorie vicine; **triangolo di efficienza** (il costo della memoria): l'iniezione non aggiunge latenza (i turni iniettati rispondono in media 210 ms più in fretta dei turni non iniettati), l'iniezione occupa circa il 10,3% dell'input per turno, e l'intera catena di distillazione ammortizza ≈2727 token di input / 240 di output per messaggio catturato (1172 chiamate, 0 fallimenti).

### Pista workflow (archivio 0.8.3 · versione a 7 scene · gruppo A 3 volte / gruppo B 1 volta, sandbox di strumenti reale): fa bene, fa sobrio?

<p align="center">
  <img src="./assets/readme/bench-workflow.svg" width="100%"
       alt="Grafico di confronto A/B della pista workflow di DSH-MemBench: completezza del segmento sonda gruppo A 59/69 (85,5%) contro gruppo B 10/23 (43,5%); confronto dei costi (gruppo B come barra di riferimento piena, media per scena) — passi 24,3 contro 41,4 (B +70%), chiamate di strumento 37,7 contro 62,1 (B +65%), token di input 266k contro 1,81M (B ×6,8); sonda della scena convenzioni di stile A 12/12 contro B 0/4; token di input per scena dei task lunghi A 266k contro B 1,81M">
</p>

**Completezza del segmento sonda: 85,5% contro 43,5% (+42 pp)**: nei segmenti di insegnamento/modifica entrambi i gruppi hanno il contesto sul posto; il segmento sonda (prosecuzione del task in una nuova sessione) è l'unica finestra di memoria pura — le tre nuove scene di prova del gruppo A (aggiornamento del know-how / disambiguazione di gemelli / continuità delle convenzioni di stile) fanno tutte 12/12 senza errori e identiche nei tre turni; il gruppo B alla sonda della scena convenzioni di stile fa **0/4** (le convenzioni di denominazione/struttura/separatore delle migliaia/piè di pagina vivono solo nella memoria, la sandbox non le lascia indovinare); nella scena di aggiornamento del processo può invece ricostruire leggendo gli script (capacità discriminante limitata dalle affordance della sandbox, annotato onestamente).

**Costo dei task lunghi: il gruppo B consuma per scena 6,8 volte i token di input del gruppo A** (1,81M contro 266k) — senza memoria l'agente avanza ri-esplorando; in modalità di ragionamento high arriva perfino a costruirsi un cantiere per sondare un processo che una sola convenzione di script avrebbe bastato a codificare. Token di output ×3 (46,2k contro 15,4k), passi +70%. È esattamente il valore centrale della memoria: **ciò che si risparmia non è la difficoltà del task, sono i viaggi di andata e ritorno inutili e la ri-esplorazione**.

### Metodologia e riproduzione

```bash
node bench/harness/run.mjs --arm A --repeats 3 --provider deepseek-official --model deepseek-v4-flash   # pista dialogo (solo gruppo A)
node bench/harness/run.mjs --track workflow --arm AB --repeats 3 ...                                  # pista workflow (gruppi A/B in parallelo)
node bench/harness/run.mjs --track lifecycle --arm A ...                                              # pista ciclo di vita (gating/off/rebuild/oblio)
node bench/harness/report.mjs --latest [dialog|workflow]                                               # report consolidato
node bench/harness/retrieval-metrics.mjs <runDir> --flood 200,600                                     # indicatori dello strato di ricerca + curva di allagamento
```

- Valutazione: giudizio programmatico `contains-all` + giudizio punto per punto di un modello giudice (testi integrali delle risposte e motivazioni archiviati in `result.json` per verifica umana); per le domande con stale (aggiornamento/catena/oblio) si penalizza solo se «il vecchio valore è enunciato come situazione attuale» — il solo racconto dell'evoluzione con valore finale corretto non penalizza; le domande a rifiuto di risposta consentono di citare il contesto reale per spiegare «perché non si sa ciò che viene chiesto»; la completezza del workflow è validata programmaticamente su prodotti + contenuti chiave (quattro tipi di criteri: controlli positivi/parole vietate/assenza del prodotto/esistenza);

- Faccia degli indicatori: oltre la tabella complessiva di accuratezza (6 tipi centrali + 4 estesi), produzione automatica degli **indicatori offline dello strato di ricerca** (recall\@5 / precisione d'iniezione / perdita d'informazioni decadute), del **triangolo di efficienza** (costo differenziale d'iniezione / quota iniettata / contabilità di distillazione ripartita per messaggio), dell'**analisi di posizione su scala** (accuratezza/inquinamento con base che cresce) e di una sezione propria della pista ciclo di vita (matrice di gating per famiglia / doppia asserzione per off / fedeltà del rebuild / oblio);

- Progresso in diretta: all'avvio del benchmark parte automaticamente un pannello di progresso locale e si apre il browser (`--no-panel` per disattivarlo) — progresso per scena/fase/messaggio di entrambi i bracci A/B, battiti e freschezza dell'attività (decidere al volo «bloccato vs processo morto»), costi cumulati che crescono camminando;

- Tutti gli indicatori provengono dall'usage riportato dal fornitore (input con ripartizione dei cache hit) e dal ripiegamento degli eventi di sessione; la percentuale di cache a regime esclude la prima richiesta di ogni sessione (base 0.8.5: 89,1% — l'iniezione di memoria non danneggia la cache);

- Uso in regressione: un giro prima e dopo la modifica del plugin, `compare.mjs` produce la tabella di confronto (intestazione d'ambiente verificata con gitSha + avviso di deriva del gruppo B testimone + confronto degli indicatori dello strato di ricerca);

- Limiti (dichiarazione onesta): macchina singola; gruppo A ×3 accorpato, gruppo B ×1 (parafulmine di costo, più rumore); giudice e testato: stessa ceppaia per la base dialogo 0.8.5, eterogenei nell'archivio workflow (glm-5.3 giudica v4-flash); libreria di scene costruita dall'autore (orientata alle scene favorevoli alla memoria; liberissimi di riprodurre); le affordance dei file della sandbox possono rivelare in parte il processo (il gruppo B può leggere gli script e risalirvi; i punti a capacità discriminante limitata sono annotati onestamente); audit degli strumenti a due livelli (rigido: violazione = penalità / morbido: solo avviso), in pratica 0 violazioni da entrambe le parti.

Report completo e dati domanda per domanda: [`bench/baseline/`](./bench/baseline/).

## Disposizione dell'archiviazione

<p align="center">
  <img src="./assets/readme/storage.svg" width="100%"
       alt="Disposizione dell'archiviazione: architettura a doppia scrittura (JSONL fonte di verità in sola aggiunta + memory.db base di ricerca principale); forme dei file: conversations/records/scenes/persona/state/pending/session-modes/embedding-source/catalogo modelli/runtime di inferenza/log e archivi di ricostruzione; tre strategie di ricerca keyword/embedding/hybrid (RRF k=60); la catena di degrado garantisce di non bloccare mai l'host">
</p>

La capacità vettoriale è disattivata per impostazione predefinita (FTS puro). Il `ctx.llm` di DSH non ha un endpoint embeddings; la ricerca semantica è fornita da una **sorgente d'embedding a tre stati** (spenta / remota / locale), commutabile a runtime dalla pagina impostazioni — vedi la sezione seguente.

## Ricerca semantica (sorgente d'embedding)

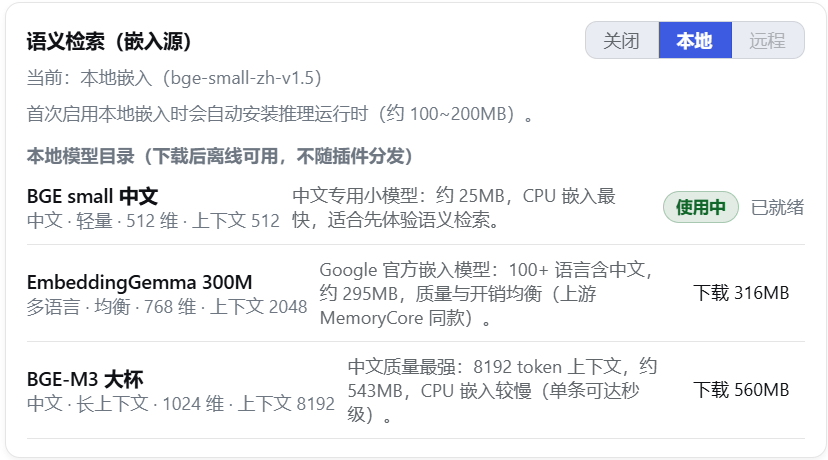
La pagina impostazioni (Memoria → Panoramica → Ricerca semantica) permette di scegliere la sorgente d'embedding, con effetto immediato, senza toccare la configurazione né riavviare:

<p align="center">
  <img src="./assets/img/EmbeddingSource.png" width="70%"
       alt="Pannello della ricerca semantica (sorgente d'embedding) della pagina impostazioni (tema chiaro): selettore a tre stati (Spento/Locale/Remota, Locale selezionato) che mostra la sorgente d'embedding attuale e l'avviso di installazione automatica del runtime al primo passaggio in locale; sotto, il catalogo dei modelli locali elenca BGE small cinese (in uso/pronto), EmbeddingGemma 300M (316 MB da scaricare) e BGE-M3 (560 MB da scaricare) con dimensioni/contesto/peso/particolarità e ingressi di download">
</p>

Tre sorgenti d'embedding: **spenta** (predefinita, ricerca a parole chiave BM25 pura), **remota** (porti qualunque servizio `/embeddings` compatibile OpenAI; le quattro chiavi `embedding.*` devono essere complete per essere selezionabile), **locale** (si sceglie un modello del catalogo integrato, inferenza **CPU** ONNX quantizzata — senza chiave API, i dati non lasciano la macchina). Il catalogo locale è una whitelist integrata nel plugin (revisione bloccata per modello + sha256 per file; non si possono scaricare repository arbitrari).

- **Download**: scaricamento a un clic dalla scheda del modello (mirror predefinito `hf-mirror.com`, ripresa dopo interruzione + verifica d'integrità sha256; se il diretto non è raggiungibile si può passare per un proxy — per impostazione predefinita rilevamento automatico delle variabili d'ambiente `HTTPS_PROXY`/`ALL_PROXY` ecc., vedi `embedding.proxy`). Se un singolo file fallisce, tentativo automatico con nuova chiave di cache (`?dshmem-retry=N`, per aggirare gli oggetti di cache corrotti che il CDN del mirror talvolta serve); se lo sha256 non torna si riscarica da zero; in caso di errore di rete la ripresa dopo interruzione resta conservata; i dati atterrano in `models/<id>/` della directory dati, cancellabili in ogni momento dalla pagina impostazioni;

- **Runtime su richiesta**: il runtime di inferenza (transformers.js, circa 100~200 MB) viene installato solo al primo passaggio in modalità locale, dentro la directory dati `runtime/` — fuori dall'albero delle dipendenze del plugin, senza toccarne la directory d'installazione); caricamento del modello e inferenza girano in un **thread worker separato**, senza congelare l'event loop dell'host (durante il calcolo degli embedding conversazione e interazioni con le pagine procedono normalmente);

- **Commutazione a caldo**: cambiare sorgente a un clic — ri-embedding integrale automatico in background (progresso visibile, annullabile; nel frattempo la ricerca degrada automaticamente alle parole chiave, senza toccare la conversazione; se cambia la dimensione, la tabella vettoriale viene ricostruita alla nuova dimensione); se la commutazione fallisce resta la vecchia sorgente e, al riavvio, riparte proprio la vecchia sorgente;

- **Regola di efficacia = tetto di distribuzione AND scelta a runtime**: `embedding.allowLocalModels=false` disattiva in blocco la modalità locale; senza le quattro chiavi `embedding.*` la modalità remota non è selezionabile (richiudibile nei deployment aziendali); lo stato è persistito in `embedding-source.json`.

## Configurazione

Le impostazioni che scavalcano i predefiniti si scrivono nel `cordis.patch.yml` del profilo stesso, come **voci patch nude al primo livello** (`id:` diretto, senza incartarle in un `insert:` — aggiungere via `insert:` una voce con lo stesso id del livello bundle provoca il fallimento d'avvio `duplicate loader entry id`):

```yaml
- id: dsh-memory
  name: dsh-prime-memory
  config:                    # le chiavi sostituiscono la riga per intero (nessuna fusione profonda); scrivere tutte le chiavi da conservare
    family: auto             # modalità predefinita delle nuove sessioni: auto | chat | work
    llm:                     # routing statico del modello di distillazione (entrambi i campi compilati = pin di distribuzione, prevale sulla
      provider: ''           # catena di routing della pagina impostazioni; vuoto = segue la rotta principale della pagina o il modello predefinito corrente)
      model: ''
```

| Campo | Predefinito | Descrizione |
| ---------------------------- | ----------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `family`                     | `auto`                  | Modalità di memoria predefinita delle nuove sessioni: `auto` (doppia famiglia automatica) \| `chat` (personale) \| `work` (lavoro); commutabile temporaneamente in sessione dal controllo nella barra di input |
| `dataDir`                    | `$DSH_HOME/memory`      | Directory dei dati |
| `capture.enabled`            | `true`                  | Cattura L0 |
| `capture.stripCodeBlocks`    | `true`                  | Rimuovere i blocchi di codice dai messaggi dell'assistente |
| `capture.maxMessageChars`    | `4000`                  | Numero massimo di caratteri per messaggio |
| `capture.redactSecrets`      | `true`                  | Oscuramento dei payload: già alla scrittura di cattura sostituisce 8 classi di segreti (PEM/Bearer/JWT/Cookie/chiavi API di fornitori/email/numeri lunghi/ID ad alta entropia) con segnaposto `[REDACTED:<KIND>]` — copre L0, gli input di distillazione e le scritture manuali; `false` ripristina il testo in chiaro (una volta attivato, il testo L0 originale non è più recuperabile) |
| `trace.enabled`              | `true`                  | Tracciamento strutturato: eventi di richiamo/distillazione in JSONL giornaliero (`<dataDir>/trace/`), consultabile e commutabile nella scheda «Log» della pagina impostazioni |
| `trace.retentionDays`        | `14`                    | Conservazione degli eventi di tracciamento in giorni (`0` = per sempre) |
| `trace.captureContent`       | `false`                 | Solo con `true` si salva il testo integrale delle query di richiamo (predefinito: solo lunghezza + sha256) |
| `extract.enabled`            | `true`                  | Estrazione L1 |
| `extract.minMessages`        | `6`                     | Soglia a regime: quando in una sessione si accumulano N nuovi messaggi parte un'estrazione L1. Nella fase di avvio la soglia efficace raddoppia da 1 fino a questo valore (memoria già al primo turno, poi accumulo automatico per risparmiare chiamate) |
| `extract.idleSeconds`        | `300`                   | Rete d'inattività: dopo N secondi di silenzio della sessione le fette non distillate vengono incassate (recupera «l'utente andato via prima della soglia»); `0` disattiva |
| `extract.backgroundMessages` | `10`                    | Numero di messaggi di contesto allegati all'estrazione (interrogati al volo da L0 per la sessione, senza contaminazione tra sessioni) |
| `extract.candidatePool`      | `5`                     | Dimensione del bacino di candidati della deduplica |
| `extract.intraBatchDedupe`   | `true`                  | Deduplica intra-batch (stesso turno/sessione): normalizzazione + clustering vettoriale (stessa famiglia/tipo) prima della deduplica LLM, così i frammenti di una conversazione non vengono fusi in un'unica memoria lunga (riduce solo numero e durata, non il picco per inferenza) |
| `l2.enabled`                 | `true`                  | Consolidamento delle scene L2 |
| `l2.minNewMemories`          | `5`                     | Soglia di nuove memorie dall'ultimo consolidamento L2 |
| `l2.maxScenes`               | `12`                    | Limite superiore di blocchi di scena |
| `l2.sceneContextLimit`       | `3`                     | Limite di scene simili allegate come testo integrale al prompt L2 |
| `l3.enabled`                 | `true`                  | Distillazione del profilo L3 |
| `l3.interval`                | `20`                    | Intervallo della distillazione L3 (in nuove memorie) |
| `recall.enabled`             | `true`                  | Richiamo automatico |
| `recall.maxResults`          | `5`                     | Limite di voci L1 iniettate prima di ogni nuovo messaggio utente |
| `recall.maxCharsPerMemory`   | `500`                   | Limite di caratteri per memoria iniettata (oltre, troncamento con invito a consultare il testo integrale con lo strumento di memoria); `0` = illimitato |
| `recall.maxTotalRecallChars` | `2000`                  | Limite totale di caratteri iniettati per turno (oltre, si scarta la coda per rilevanza); `0` = illimitato |
| `recall.timeoutMs`           | `5000`                  | Budget complessivo del richiamo (ms): al superamento si salta il turno d'iniezione senza bloccare la conversazione; `0` = senza limite di tempo |
| `recall.includePersona`      | `true`                  | Inietta il contesto del profilo nel prompt di sistema (`<user-persona>`, zona stabile) |
| `recall.includeSceneNav`     | `true`                  | Inietta la navigazione delle scene nel prompt di sistema (`<scene-navigation>`, zona stabile) |
| `recall.strategy`            | `hybrid`                | Strategia di ricerca: `keyword` / `embedding` / `hybrid` |
| `recall.scoreThreshold`      | `0.3`                   | Soglia di punteggio del richiamo (sotto, nessuna iniezione; efficace solo per le strategie keyword/embedding, hybrid non filtra prima della fusione; il percorso strumento non filtra) |
| `recall.decayHalfLifeDays`   | `30`                    | Emivita del decadimento di freschezza del richiamo (giorni, 0 = disattivato): l'ordinamento pondera morbido con `rilevanza × max(0.5, 0.5^(giorni dall'aggiornamento/emivita))` — tra candidati di rilevanza simile passano prima le memorie fresche (rotazione dei posti), una memoria vecchia perde al più metà del punteggio d'ordinamento (pavimento di garanzia: i fatti di lungo periodo non affondano) |
| `embedding.enabled`          | `false`                 | Interruttore della ricerca vettoriale; spento si gira in FTS puro |
| `embedding.baseUrl`          | vuoto                   | Indirizzo di un servizio /embeddings compatibile OpenAI (es. `https://api.siliconflow.cn/v1`) |
| `embedding.apiKey`           | vuoto                   | Chiave API |
| `embedding.model`            | vuoto                   | Nome del modello d'embedding |
| `embedding.dimensions`       | `0`                     | Dimensione dei vettori (obbligatoria se attiva, deve corrispondere all'output del modello) |
| `embedding.maxInputChars`    | `5000`                  | Numero massimo di caratteri per testo (troncamento oltre) |
| `embedding.maxInputTokens`   | `0`                     | Budget di **token** per testo per l'embedding locale: `0` (default) = min(finestra del modello, limite 1536); >0 = esplicito, ridotto con un warn se oltre il limite. Non è lo stesso limite della riga sopra: quello in caratteri copre solo modalità remota e dimensione IPC, la protezione locale contro cadute/memoria deve essere in token (#22) |
| `embedding.respawnOnCrash`   | `true`                  | Se il processo figlio dell'embedding locale si **auto-ripara in modo limitato** dopo un arresto brusco (#22): default attivo — re-fork + ri-riscaldamento ≤2 volte per finestra da 60s, i lotti ripartono una volta dal checkpoint live (i vettori di testa persi col figlio ucciso li recupera il backfill); disattivo = comportamento precedente (un arresto blocca fino a riavvio host / cambio sorgente). Revoca deliberatamente la nota 0.26.25 "nessuna auto-riparazione". Tre strati = guard-rail(1536) / riduzione del picco(memPattern) / auto-riparazione(respawn). |
| `embedding.timeoutMs`        | `10000`                 | Timeout di una singola chiamata d'embedding (ms) |
| `embedding.allowLocalModels` | `true`                  | Consente la modalità d'embedding locale (tetto di distribuzione: disattivata, la pagina impostazioni non può scaricare modelli né passare in locale) |
| `embedding.mirror`           | `https://hf-mirror.com` | Radice del mirror di scaricamento dei modelli locali (riportabile all'ufficiale `https://huggingface.co`) |
| `embedding.proxy`            | `''`                    | Proxy per il download dei modelli, tre stati: `''` (predefinito) = rilevamento automatico delle variabili d'ambiente del proxy (`HTTPS_PROXY`/`ALL_PROXY` ecc., rispettando `NO_PROXY`); `none` = disattivazione, connessione diretta forzata; altro valore = URL del proxy (es. `http://127.0.0.1:7890`). Il collegamento diretto al mirror è intermittente nelle reti cinesi (alternanza di timeout diretti e byte inquinati); su una macchina con proxy conviene lasciare il rilevamento automatico predefinito |
| `llm.provider/model`         | vuoto                   | Routing statico del modello di distillazione (pin di distribuzione): con provider e model **entrambi compilati** la rotta di distillazione è bloccata, prevale sulla catena di routing runtime della pagina impostazioni e sul modello predefinito (la distribuzione può forzare la distillazione su una rotta specifica); vuoto = segue «rotta principale della catena di routing della pagina impostazioni → modello predefinito». A runtime l'**editor della catena di routing di distillazione** (pagina impostazioni → Memoria → Panoramica → Parametri di distillazione) permette di configurare rotta principale e catena di fallback (da scegliere tra i **fornitori configurati** (incluse le aggiunte in dsh → Impostazioni → Modelli); la riga della rotta principale può restare vuota e seguire il modello predefinito); se non vuoto assume interamente il controllo di questa configurazione statica, effetto immediato senza riavvio |
| `llm.fallbacks`              | `[]`                    | Catena di fallback della distillazione: elenco di rotte di riserva tentate una dopo l'altra, nell'ordine delle voci, quando la rotta principale fallisce (errore/troncamento/errore di rete/**output vuoto**); voce = `{provider, model, reasoningEffort?}` (un livello non vuoto scavalca il `llm.reasoningEffort` globale, sempre limitato dalle capacità del modello); le voci identiche alla rotta principale vengono saltate automaticamente; **ogni rotta dispone dell'intero** **`timeoutMs`**; se tutte falliscono si passa al meccanismo esistente di re tentativo con back-off per sessione. Array vuoto (predefinito) = comportamento a rotta singola invariato (vedi sotto [Catena di fallback della distillazione e modelli lenti al TTFT](#catena-di-fallback-della-distillazione-e-modelli-lenti-al-ttft)); quando la catena di routing runtime della pagina impostazioni (`distillChain`) è non vuota, **assume interamente** rotta principale e catena di fallback (catena di una riga = esplicitamente senza fallback); vuota = segue questa configurazione |
| `llm.layerRoutes`            | `{}`                    | **Routing per strato** della distillazione: ogni chiave di strato `l1`/`l2`/`l3` riceve una **catena completa** (voci come `llm.fallbacks`, **la riga di testa deve dichiarare esplicitamente provider+model**); se non vuota **sostituisce integralmente** la risoluzione di quello strato (rotta principale e fallback dello strato passano alla catena di strato, la catena globale non partecipa); vuota/assente = lo strato segue il globale; `l1` governa insieme i due punti di chiamata estrazione+deduplica. A runtime si modifica strato per strato nel pannello a segmenti «Parametri di distillazione» della pagina impostazioni (prevale su questa configurazione statica); il pin di distribuzione non abroga le catene di strato statiche (entrambe sono configurazione di distribuzione, stesso precedente della catena di fallback). Ortogonale alla catena di fallback e componibile — una catena per strato (ADR-0005) |
| `llm.maxTokens`              | `65536`                 | Valvola di soccorso dell'output totale per le chiamate non stratificate. Ogni strato di distillazione ha un proprio budget (estrazione 16k / deduplica 8k / L2 32k / L3 16k; nei livelli di ragionamento high/xhigh/max automaticamente ×4, perché il reasoning non divorì il budget); i budget per strato sono regolabili a runtime (pagina impostazioni → Memoria → Panoramica → Parametri di distillazione; vuoto/0 = predefiniti integrati) |
| `llm.reasoningEffort`        | vuoto                   | Livello di ragionamento della distillazione: stringa vuota = **auto** (risolto secondo le capacità del modello: livello predefinito del modello → `high`); un valore esplicito (`off`/`none`/`minimal`/`low`/`medium`/`high`/`xhigh`/`max`) viene inviato solo se il modello dichiara di supportarlo — i vocabolari di effort differiscono tra fornitori (deepseek accetta `off`, la famiglia OpenAI dice `none`, i modelli senza livelli dichiarati non ricevono nulla), un livello non supportato viene degradato automaticamente a «non inviare» con un solo avviso; ai livelli high/xhigh/max il budget di output è automaticamente ×4. A runtime l'editor della catena di routing permette di scavalcare il livello **rotta per rotta** (menu a tendina in linea, vocabolario mostrato in diretta secondo le capacità dichiarate di ciascun modello, predefinito segue questo valore) |
| `llm.temperature`            | `0.3`                   | Temperatura di distillazione |
| `llm.maxInputChars`          | `700000`                | Budget di caratteri d'input per chiamata di distillazione (gli input L1 in eccesso vengono automaticamente estratti a blocchi); regolabile a runtime (pagina impostazioni → Parametri di distillazione → Budget di input; vuoto/0 = segue questo valore) |
| `llm.timeoutMs`              | `120000`                | Timeout di una singola chiamata di distillazione (ms) |
| `tokenCost.retentionDays`    | `365`                   | Conservazione in giorni del dettaglio dei costi di distillazione (tabella token\_cost), con pulizia scorrevole delle righe più vecchie alla scrittura; `0` = conservazione illimitata. Il tetto della finestra «ultimi N giorni» del cruscotto costi coincide con questo valore |
| `tools`                      | `true`                  | Registrare o meno gli strumenti di memoria richiamabili dal modello |
| `benchControl`               | `false`                 | Registra il servizio di controllo bench (attivazione di rebuild in-process / impostazione delle modalità di sessione / istantanea dell'uso di distillazione, per la pista lifecycle del benchmark). Spento per impostazione predefinita — superficie nulla in produzione, non attivarlo a cuor leggero |
| `scope` | `global` | **Ambito di archiviazione** (visibilità): `global` (predefinito) = visibile tra gli spazi di lavoro; `workspace` = la **famiglia `work`** isolata per spazio di lavoro. Ortogonale a `family` (tipo di contenuto) — i due assi pongono domande diverse, tutti e quattro i quadranti esistono (`chat×global` / `chat×workspace` / `work×global` / `work×workspace`). La famiglia `chat` resta globale per impostazione predefinita: le memorie personali devono attraversare i progetti. **Con `global` come predefinito il comportamento è identico alla lettera a quello antecedente l'introduzione della chiave** — tutti i dati a radice singola esistenti sono attribuiti a `global`; la migrazione si limita a etichettare l'appartenenza, senza spostare né cancellare ([ADR-0008](./docs/adr/0008-storage-scope-vs-family.md) / [ADR-0009](./docs/adr/0009-workspace-identity-source.md)). Se lo spazio di lavoro della sessione non è determinabile si ricade su `global` (senza eccezioni, senza bloccare) |
| `conflictFreeze.enabled`     | `false`                 | Interruttore generale del **congelamento delle contraddizioni**. Una volta attivo, il vocabolario di decisione della deduplica guadagna l'azione `conflict`: quando il LLM giudica che «entrambe le versioni sembrano corrette e la macchina non può decidere», **non effettua più `update` o `merge` automatici**, ma **parcheggia** la coppia in una coda di arbitrato — la nuova memoria entra regolarmente nella base, **il contenuto di entrambe le parti resta intatto**, e il nuovo strumento `memory_resolve_conflict` sottopone l'arbitrato alla persona. Spento, il prompt di deduplica è **identico alla lettera** a quello senza la funzionalità (zero deriva). Spento per impostazione predefinita: il congelamento consuma attenzione umana, non può essere attivo per tutti per default ([ADR-0010](./docs/adr/0010-conflict-freeze-default-off-and-timeout.md)) |
| `conflictFreeze.maxPending`  | `100`                   | Limite della coda d'arbitrato. Raggiunto il numero massimo di casi in sospeso, i nuovi conflitti **non vengono più parcheggiati** e vengono risolti sul posto secondo il winner/loser indicato dal LLM (la coppia **resta comunque registrata in coda**, con `resolution` = `auto` per distinguerla dalle conclusioni umane). La semantica è «**non accettarne altri**», non «cancellare furtivamente i vecchi» — da qui la limitatezza, senza perdere le richieste d'arbitrato che nessuno ha ancora visto |
| `conflictFreeze.timeoutDays` | `30`                    | Degradazione per scadenza (giorni): le coppie parcheggiate da più di questo numero di giorni vengono risolte automaticamente **all'inizio del turno di distillazione successivo** (come sopra, registrate con `resolution=auto`). `0` = **nessuna** degradazione per scadenza (disattivazione esplicita, non «tutti subito fuori tempo»). Senza valvola di sicurezza, «due memorie contraddittorie richiamate fianco a fianco» resterebbe per sempre nella base |

### Catena di fallback della distillazione e modelli lenti al TTFT

Presso alcuni fornitori di inferenza, le fasce gratuite/lente arrivano a un **ritardo sul primo token (TTFT) di oltre 20 secondi**, mentre certi gateway a monte troncano dopo circa 20 secondi di silenzio della connessione — le chiamate di distillazione falliscono quindi in modo fisso a ~20 s (`llm aborted`) e il timeout di 120 s del plugin non fa in tempo ad attivarsi (scenario riscontrato nel [#31](https://github.com/drscrewdriver/dsh-prime-memory/issues/31)). Tre livelli di attenuazione, da prendere secondo necessità:

1. **Cambiare rotta** (il più diretto): pagina impostazioni → Memoria → Panoramica → Parametri di distillazione, l'editor della catena di routing cambia al volo la rotta principale (o mette in testa una rotta veloce), oppure si fissa staticamente `llm.provider`/`llm.model`.

2. **Catena di fallback** (degrado automatico): se la rotta principale fallisce, le rotte di riserva subentrano in ordine, senza intervento umano:

   ```yaml
   llm:
     provider: opencode-go          # rotta principale (si può anche non fissare: segue la rotta principale della pagina impostazioni / il modello predefinito)
     model: ox-alpha-free
     fallbacks:                     # l'ordine delle voci = priorità di degrado; senza configurazione resta il comportamento a rotta singola
       - provider: opencode-go
         model: deepseek-v4-flash
         reasoningEffort: low       # facoltativo: scavalco del livello per questa rotta (predefinito: segue il globale)
       - provider: deepseek-official
         model: deepseek-v4-flash
   ```

3. **Routing per strato** (ognuno per il proprio canale): gli strati di distillazione hanno esigenze diverse dal modello (L1, molto frequente, vuole economicità, rapidità e stabilità;
   L3, raro, tollera un primo pacchetto lento ma richiede forti capacità) — agli strati divergenti si può assegnare una catena propria: **una catena di fallback completa per strato**,
   gli strati non configurati continuano sulla catena globale:

   ```yaml
   llm:
     layerRoutes:                  # routing indipendente per strato (#34); la riga di testa deve dichiarare provider+model espliciti
       l1:                         # l1 governa insieme estrazione + deduplica: una catena economica, rapida e stabile
         - provider: opencode-go
           model: deepseek-v4-flash
           reasoningEffort: low
         - provider: deepseek-official   # fallback interno allo strato: un guasto di L1 degrada solo fino a qui, non nella catena globale
           model: deepseek-v4-flash
       l3:                         # distillazione del profilo L3: input rari e grandi, una catena ad alte capacità
         - provider: deepseek-official
           model: deepseek-v4-flash
           reasoningEffort: high
   ```

   Si modifica anche strato per strato a runtime nel **pannello a segmenti** (Globale / L1 / L2 / L3)
   della pagina impostazioni → Memoria → Panoramica → Parametri di distillazione; priorità interna allo strato:
   catena di strato runtime > catena di strato statica di questo YAML > catena globale predefinita,
   con ripiego gradino per gradino.

   Fallimento = errore / troncamento / errore di rete / **output vuoto** (lo stream termina regolarmente ma con 0 caratteri — per la distillazione è compromesso per forza in fase di parsing, per questo riclassificato come fallimento della rotta anziché restituire una stringa vuota); un annullamento da parte del chiamante non attiva il degrado; ogni rotta dispone dell'**intero** `llm.timeoutMs` (un budget condiviso darebbe a una rotta di riserva lenta al primo pacchetto una finestra inferiore al suo vero tempo di primo pacchetto, rendendo la catena di fallback un ornamento); il costo dei token è contabilizzato a ogni tentativo (anche i falliti, compresi i token ricevuti prima dell'interruzione dello stream), e la chiamata riuscita è attribuita alla rotta che l'ha effettivamente servita. La catena di routing si regola anche a runtime nell'editor «Catena di routing di distillazione» (pagina impostazioni → Memoria → Panoramica → Parametri di distillazione, senza toccare la configurazione né riavviare); questo YAML è adatto a chi distribuisce e vuole fissare una catena statica.

4. **Alzare il timeout**: `llm.timeoutMs` serve solo se la rotta è davvero lenta ma il gateway non tronca; quando il gateway tronca a 20 s alzare il timeout del plugin è inutile — usate i primi due livelli.

## Log e risoluzione dei problemi

L'host dsh scrive i log del plugin sulla console; il plugin inoltre vi rispecchia da livello info in su in `memory.log` della directory dati.
Percorso tipico dei log di un turno di conversazione: `L0 捕获` → `L0 落盘` → `蒸馏管线开始` → `LLM 调用（输入/输出 字符数、耗时）` → `L1 阶段完成` → `管线结束`; il turno successivo comincia con `召回注入 N 条 L1`. Un output vuoto del LLM
arriva con diagnosi completa (finish reason / conteggio token / estratto del reasoning); un fallimento di parsing del JSON registra i primi 400 caratteri
dell'output grezzo del modello; tutti i fallimenti avvisano con la prima riga dello stack. La fonte di verità JSONL è appesa turno per turno e si affida al write-back del SO (nessun
fsync riga per riga): con un blackout o un crash estremo si perde al più una piccola coda finale; la base di ricerca può essere reimportata integralmente dalla fonte di verità con «Ricostruisci la memoria».

## Differenze rispetto a MemoryCore

- Pipeline completa incorporata (senza dipendere da un gateway esterno); la distillazione riutilizza il LLM di DSH stesso;

- L2/L3 passano da «il LLM maneggia strumenti sui file» a «il LLM produce JSON d'operazioni / documenti integrali, lato ingegneria li esegue»;

- Il punto d'iniezione del richiamo è `agent/pre-step` (messaggio sintetico lato messaggi, semantica di sostituzione del pre-step ufficiale) + `systemPrompt.context` in scope agent (zone stabili profilo/navigazione, eventi/servizi nativi di DSH);

- Archiviazione/ricerca: versione monoutente ricavata dal backend sqlite ufficiale (senza colonne d'isolamento multi-tenant, backend cloud TCVDB, tabelle d'audit;
  la tokenizzazione coincide con l'ufficiale tramite jieba — binario precompilato @node-rs/jieba + unione con i bigrammi CJK,
  i token alimentano i colpi di parola intero esatti di BM25, i bigrammi garantiscono il richiamo dei sotto-parole; se il caricamento fallisce, ripiego automatico sui soli bigrammi,
  l'indice FTS si ricostruisce automaticamente in base alla versione del tokenizzatore).

## Uscita di scena, ripristino e pulizia delle memorie

La cancellazione esiste in **due gradi**, dettati dal loro costo: **il grado reversibile è il predefinito**, quello irreversibile va richiesto esplicitamente e porta con sé il proprio esportato.

| Azione | Endpoint / strumento | Reversibile | Descrizione |
| --- | --- | --- | --- |
| Uscita di scena (cancellazione logica) | `memory_delete` · `dsh-memory/records-delete` | ✅ | La riga della tabella principale resta + `valid_to` chiuso + marcatore di sostituzione scritto; vengono tolti solo le righe FTS/vettore. **Per impostazione predefinita si fa uscire di scena 1 solo voce**; per lotti passate `ids` esatti, non affidatevi al matching semantico |
| Recupero | `dsh-memory/records-restore` | — | Marcatore di uscita rimosso + indici ricostruiti: il record torna nel richiamo |
| Pulizia fisica | `dsh-memory/cleanup-retired` | ❌ | **L'unica azione irreversibile** del plugin. **Prova a vuoto per default** (omettere `dryRun` significa non cancellare nulla); anche in esecuzione esplicita, prima viene scattato un istantaneo dell'intera base e **verificato per hash del contenuto** — se non torna, stop e nessuna cancellazione |
| Elenco degli istantanei | `dsh-memory/snapshots-list` | — | Elenca gli istantanei in `snapshots/` dotati di manifesto valido (con motivo e numero di voci) |
| Reimmissione dall'istantaneo | `dsh-memory/snapshot-restore` | — | Riscrive i record ripuliti. **Prova a vuoto per default**; accetta solo nomi di directory d'istantaneo, non percorsi |

Le tre vie d'uscita — condanna all'arbitrato, sostituzione per deduplica (`update`/`merge`), cancellazione manuale — **condividono lo stesso primitivo**, quindi «cancellare» ha in tutti e tre i posti la medesima semantica: tutto è recuperabile.

### Com'è fatto il «farmaci anti pentimento» della pulizia

Prima di ogni cancellazione fisica bisogna scattare l'istantaneo e verificarlo (vedi tabella sopra). La strada del ritorno è:

1. `dsh-memory/snapshots-list` — ottenere il nome della directory d'istantaneo (nella forma `l1-<marca temporale>-<motivo>`);
2. `dsh-memory/snapshot-restore` — prima in prova a vuoto per vedere `missing` (le voci davvero recuperabili, non il totale dell'istantaneo), poi riscrivere con `dryRun:false` esplicito.

L'ingresso di ripristino **accetta solo nomi di directory, mai percorsi**: altrimenti questo RPC verrebbe a valere anche «leggi una directory qualsiasi e scrivi il suo contenuto nella base di ricerca». Il ripristino in sé è un upsert idempotente, rieseguibile senza rischi.

> **Una semantica da conoscere assolutamente**: `cleanup-retired` pulisce solo i record **già usciti di scena**, e l'istantaneo viene scattato **prima** della cancellazione — quindi ogni voce recuperabile da un istantaneo di pulizia porta il marcatore di uscita. Per impostazione predefinita `snapshot-restore` si limita a riscrivere le righe nella tabella principale (e riporta onestamente i `stillRetired`): **«tornato nella tabella principale» ≠ «tornato nel richiamo»**; per un vero rollback in un solo passo aggiungete `unretire: true`, o chiamate subito dopo `records-restore` su quel lotto di id.

## Roadmap

Funzionalità in programma — segnalate bisogni e priorità nelle [Issues](https://github.com/drscrewdriver/dsh-prime-memory/issues):

- [ ] **Consapevolezza dei branch git**: associare le memorie al branch git corrente; filtrare/pesare il richiamo per branch (ortogonale alle modalità di memoria esistenti)

- [ ] **Import delle memorie da Claude Code / Codex**: migrazione a un clic degli asset di memoria esistenti (`CLAUDE.md`, file di memoria di Claude Code, `AGENTS.md` di Codex ecc.); una volta importate entrano nella pipeline di distillazione stratificata

## Ringraziamenti

Il diretto antenato di questo repository è [JunNanLYS/dsh-layered-memory](https://github.com/JunNanLYS/dsh-layered-memory)
— il plugin di memoria a distillazione stratificata lato DSH. Grazie all'autore originale **JunNanLYS** per aver reso pubblico il progetto: questo repository ne ha riscritto lo strato d'implementazione
(il primo commit `0b506b8` è già «sgombero per riscrittura in clean room — rimossa la vecchia implementazione e gli artefatti di build»); documentazione, immagini e architettura dei moduli seguono l'upstream.
Rispetto all'upstream, questo repository aggiunge 12 strumenti di memoria orientati all'agente (incluse le scritture ad alto privilegio `memory_add` / `memory_delete` /
`memory_import`, la serie di controllo della ruminazione `memory_ruminate`, il grafo di memoria `memory_search_graph` /
`memory_expand_graph_node`, la retrotracciabilità delle decisioni `memory_receipts`, l'arbitraggio delle contraddizioni `memory_resolve_conflict`),
il trasporto di memoria tra strumenti `skills/memport`, oltre alla dichiarazione degli screenshot per lo store.

Due di questi strumenti servono la **tracciabilità**:

- `memory_receipts` — risale a «**come** è nata questa memoria». Ogni decisione di deduplica L1 lascia una ricevuta
  (**riepilogo del bacino di candidati visto al momento della decisione** + conclusione); per un record si può chiedere «da quale turno proviene, quale bacino era visibile allora»,
  per un lotto «cosa è stato giudicato in quel turno». La ricevuta deve esistere **prima** dell'evento — l'istantaneo d'input non può essere ricostituito dopo
  ([ADR-0006](./docs/adr/0006-l1-decision-receipts.md)).
- `memory_resolve_conflict` — arbitra le coppie in conflitto parcheggiate dal **congelamento delle contraddizioni** (vedi la configurazione `conflictFreeze.*`).
  Conclusioni `winner` / `loser` / `both`: se una parte è dichiarata vera, l'altra esce dalla ricerca; `both` significa
  che si tratta di due fatti indipendenti e entrambi vengono conservati.

Il nucleo delle capacità di memoria (pipeline di distillazione stratificata, design dei prompt, architettura di archiviazione a doppia scrittura) è ispirato al **MemoryCore** del progetto
[TencentCloud/TencentDB-Agent-Memory](https://github.com/TencentCloud/TencentDB-Agent-Memory); grazie al progetto originale per aver aperto design e implementazione.

## License

[MIT](LICENSE)