<div align="center">

<img src="./assets/img/Hero.png" width="100%"
alt="Bannière hero de DeepSeek Harness : les conversations sont automatiquement distillées en mémoires stratifiées, rappelées et injectées avant chaque étape du modèle — à droite, les bulles de conversation se dissolvent couche par couche en trois bandes lumineuses de plus en plus éclatantes qui alimentent une capsule de verre ornée d'une sphère émissive et d'une orbite en dégradé (graduations 日常·工作·智能·关闭, quatre niveaux), les fils de lumière qui reviennent illustrant l'injection de rappel">

# dsh-prime-memory

**Plugin de mémoire à distillation stratifiée pour DeepSeek Harness : la conversation est traitée en arrière-plan — capture L0 → mémoires atomiques L1 → consolidation de scènes L2 → distillation de profil L3 — et les mémoires pertinentes sont injectées automatiquement dans le contexte avant chaque étape du modèle.**

[English](README.en.md) · [中文](README.md) · [Dernière version](https://github.com/drscrewdriver/dsh-prime-memory/releases/latest) · [Signaler un problème](https://github.com/drscrewdriver/dsh-prime-memory/issues)

[![npm version](https://img.shields.io/npm/v/dsh-prime-memory?color=6f83ff\&style=flat-square\&label=npm)](https://www.npmjs.com/package/dsh-prime-memory)
[![DSH 0.2.0-rc.1](https://img.shields.io/badge/DSH-0.2.0--rc.1-8b5cf6?style=flat-square)](https://github.com/deepseek-ai/deepseek-harness)
[![MIT License](https://img.shields.io/badge/license-MIT-536990?style=flat-square)](LICENSE)

</div>

<details open>
<summary>🌐 Langue / Language</summary>

- [中文 README](./README.md)
- [English README](./README.en.md)
- [日本語 README](./README.ja.md)
- [한국어 README](./README.ko.md)
- [README en français](./README.fr.md)
- [README auf Deutsch](./README.de.md)
- [README in italiano](./README.it.md)
- [README на русском](./README.ru.md)
- [README en español](./README.es.md)
- [安装指南（中文）](./INSTALL.md)
- [Installation guide (English)](./INSTALL.en.md)
- [日本語インストールガイド](./INSTALL.ja.md)
- [한국어 설치 안내](./INSTALL.ko.md)
- [Guide d'installation (français)](./INSTALL.fr.md)
- [Installationsanleitung (Deutsch)](./INSTALL.de.md)
- [Guida all'installazione (Italiano)](./INSTALL.it.md)
- [Руководство по установке (Русский)](./INSTALL.ru.md)
- [Guía de instalación (Español)](./INSTALL.es.md)
- [更新日志（中文）](./CHANGELOG.md)
- [Changelog (English)](./CHANGELOG.en.md)
- [日本語 changelog](./CHANGELOG.ja.md)
- [한국어 changelog](./CHANGELOG.ko.md)
- [Changelog en français](./CHANGELOG.fr.md)
- [Changelog auf Deutsch](./CHANGELOG.de.md)
- [Changelog in italiano](./CHANGELOG.it.md)
- [Changelog на русском](./CHANGELOG.ru.md)
- [Changelog en español](./CHANGELOG.es.md)

</details>

## Matrice de compatibilité des versions de DSH

| Version de DSH | API d'enregistrement settings | Statut |
|---|---|---|
| 0.1.1-rc.2 | `settings.register()` (scope live) | ✅ Vérifié |
| 0.1.2-rc.1 | `settings.register()` (repli disponible) | ⚠️ Déduit de la documentation du framework, non testé en conditions réelles |
| 0.1.3-rc.1 | `settings.register()` (repli disponible) | ⚠️ Non testé (à partir de 0.1.3, les namespaces sont devenus de simples chaînes ; ce plugin est compatible) |
| 0.1.5-rc.2 | `settings.register()` (repli disponible) | ⚠️ Non testé ; sémantique de la surface Session V3 et emplacements barre de saisie/paramètres en attente de régression |
| 0.2.0-rc.1 | `settings.register()` (scope live) | ✅ Ligne d'adaptation en cours (re câblage de l'événement agent/session-start → agent/created) |

> Mécanisme de compatibilité : l'enregistrement settings passe par trois branches à l'exécution
> (`register` → pont `installSection` → dégradation en mode toujours actif),
> voir l'entrée 0.11.0 du [CHANGELOG.md](./CHANGELOG.md). `dsh.plugin.json` déclare
> `engines.dsh` 为逐 rc 精确枚举串（0.1.0-rc.2 → 0.2.1-rc.5，20 rc）.

## Démarrage rapide

Nécessite Node ≥ 22.16. Deux styles d'invocation au choix (le préfixe `npx` peut remplacer `dsh` dans n'importe laquelle des commandes ci-dessous) :

```bash
# Méthode 1 : lancer le CLI officiel directement via npx (pas besoin de dsh préinstallé ; version épinglable, ex. dsh-prime-memory@0.8.4)
npx -y @deepseek-ai/dsh plugin --profile web add dsh-prime-memory

# Méthode 2 : CLI dsh déjà installé (dsh est un relais pnpm ; si pnpm manque, commencez par npm i -g pnpm)
dsh plugin --profile web add dsh-prime-memory

# Sources de paquet alternatives : dépôt GitHub / chemin local (développement/débogage ; link: pointe vers le dépôt, npm run build + redémarrage de dsh suffisent)
dsh plugin --profile web add https://github.com/drscrewdriver/dsh-prime-memory
dsh plugin --profile web add /path/to/dsh-prime-memory
```

### Laisser l'agent installer (recommandé)

Si l'agent actuel peut exécuter des commandes de terminal, envoyez-lui le message suivant en entier :

```text
Veuillez installer le plugin dsh-prime-memory pour le profil web de DeepSeek Harness.

Exécutez uniquement les deux commandes suivantes, sans modifier d'autres profils :
dsh plugin --profile web add dsh-prime-memory
dsh --profile web --dump-config

Une fois que dsh-prime-memory apparaît dans la sortie, confirmez-moi le résultat de l'installation.
Ne fermez pas et ne redémarrez pas vous-même le DSH en cours d'exécution ; après l'installation, rappelez-moi de redémarrer manuellement le DSH Web Host.
```

L'agent doit vous rapporter le résultat de l'installation et vous indiquer clairement si
`dsh-prime-memory` figure bien dans la configuration.

Ce paquet déclare une couche de composition `dsh.bundle` (`cordis.patch.yml`) ; après l'installation,
**la ligne du plugin est montée automatiquement** — inutile de retoucher à la main
`$DSH_HOME/profiles/web/cordis.patch.yml`. Redémarrez ensuite DeepSeek Harness et vérifiez :
l'apparition des répertoires `conversations/ records/ scenes/` et de `memory.db` sous
`~/.dsh/memory/` signe l'application réussie du plugin ; la page « Mémoire » dans les paramètres
et le pill de mode dans la barre de saisie signent la moitié client prête.

**Désinstallation** : `dsh plugin --profile web remove dsh-prime-memory` + redémarrage. Les données restent dans
`~/.dsh/memory/` ; supprimez tout le répertoire à la main quand vous n'en avez plus besoin.

### Développer depuis les sources

```bash
git clone https://github.com/drscrewdriver/dsh-prime-memory
cd dsh-prime-memory
npm install && npm run build
dsh plugin --profile web add .        # installation link: ; après modification du code, npm run build + redémarrage de dsh suffisent
npm run smoke                         # test de fumée (recompiler d'abord : voir commande ci-dessous)
npx tsc src/smoke.ts --outDir dist-smoke --module nodenext --moduleResolution nodenext --target es2022 --strict --skipLibCheck --esModuleInterop
```

## Flux de données à l'exécution

<p align="center">
  <img src="./assets/readme/flow.svg" width="100%"
       alt="Flux de données à l'exécution de dsh-prime-memory : à gauche, les événements de conversation de l'utilisateur et de l'assistant alimentent le plugin (capture L0, distillation L1–L3, rappel, outils de mémoire) ; le plugin injecte les mémoires pertinentes dans le noyau DSH à droite via agent/pre-step ; la distillation réutilise le ctx.llm du noyau, les données sont écrites en double dans ~/.dsh/memory/">
</p>

Le plugin se branche sur les événements natifs de dsh (`session/event` pour la capture, `agent/pre-step` pour l'injection) ; les appels de distillation réutilisent le `ctx.llm` de l'hôte. Le rappel prend la forme d'une **injection côté messages** : les mémoires pertinentes arrivent comme un message synthétique placé avant le nouveau message de l'utilisateur, affiché dans le flux sous la forme d'une ligne \*\*« Injection de contexte · memory »\*\* (cliquez pour voir le contenu retenu) — l'utilisateur constate directement que « la mémoire agit ». L'injection est soumise à un budget de longueur et à un budget de temps ; au-delà, troncature ou saut, jamais au prix de ralentir la conversation. **Déduplication intra-session** : une mémoire déjà injectée ne l'est pas une seconde fois (le contexte du modèle la contient déjà, ce qui économise des tokens quand l'utilisateur revient sur le même sujet) ; le compteur se réinitialise quand le contexte est comprimé par `/compact` ou vidé, et la mémoire peut alors être réinjectée ; une mémoire mise à jour (nouvel id en cas de changement de contenu) n'est plus pénalisée par l'ancien marquage. **Pondération de fraîcheur** : le tri du rappel applique une pondération douce `pertinence × max(0.5, 0.5^(jours depuis la dernière mise à jour/30))` — entre candidats de pertinence proche, les mémoires fraîches passent d'abord (rotation naturelle des places), tandis qu'une vieille mémoire suffisamment pertinente reste rappelée normalement (le plancher limite la perte à la moitié du score de tri au maximum : les faits de long terme ne coulent pas au fond) ; `recall.decayHalfLifeDays` est réglable, 0 = désactivé.

**Tableau de bord des coûts** : le coût en tokens de chaque appel LLM de distillation (extraction/déduplication/L2/L3) est consigné par `provider/model` dans une table de détail SQLite (durée de conservation configurable, 365 jours par défaut, nettoyage glissant à l'écriture ; un échec de comptabilisation se contente d'alerter et ne bloque jamais la distillation) ; page de paramètres → Mémoire → onglet **Coûts** pour visualiser : courbe de tendance colorée par modèle (granularité jour/semaine/mois + fenêtre des N derniers jours + filtre par niveau L1/L2/L3), tableau niveau × fenêtre temporelle (nombre d'appels / tokens de sortie et de réflexion / moyenne / médiane), cumuls par modèle — le coût de la distillation se lit d'un coup d'œil. Les entrées sont comptées en caractères (l'usage en streaming de dsh n'inclut pas les tokens d'entrée) ; les sorties et la réflexion sont comptées en tokens.

**Outils de mémoire (3) :**

- memory\_search

- conversation\_search

- memory\_read\_scene

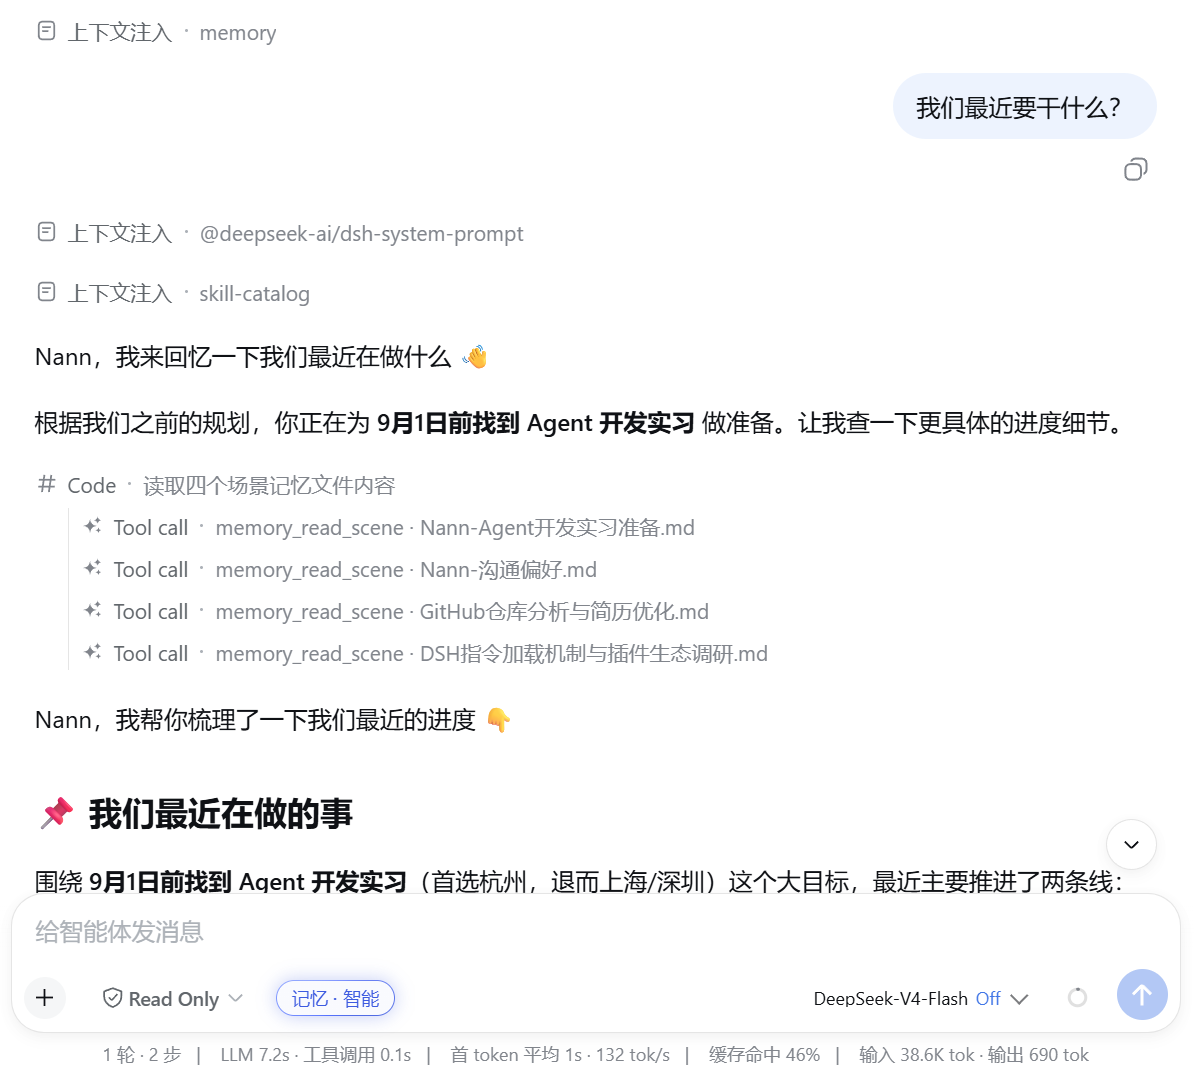
Enregistrement réel sur machine — l'allure de l'injection de rappel et des appels d'outils dans la conversation : la ligne « Injection de contexte · memory » fait d'abord remonter les mémoires pertinentes, puis le modèle lit au besoin le bloc de scène via `memory_read_scene` et répond directement de mémoire :

<p align="center">
  <img src="./assets/img/MemoryTools.png" width="60%"
       alt="Capture réelle de l'interface de conversation (thème clair) : au-dessus du message utilisateur « Que devons-nous faire récemment ? » on voit la ligne « Injection de contexte · memory » ; avant de répondre, l'assistant liste 4 appels de l'outil memory_read_scene (paramètres : noms de fichiers .md des blocs de scène), puis récapitule de mémoire les objectifs récents et la feuille de route">
</p>

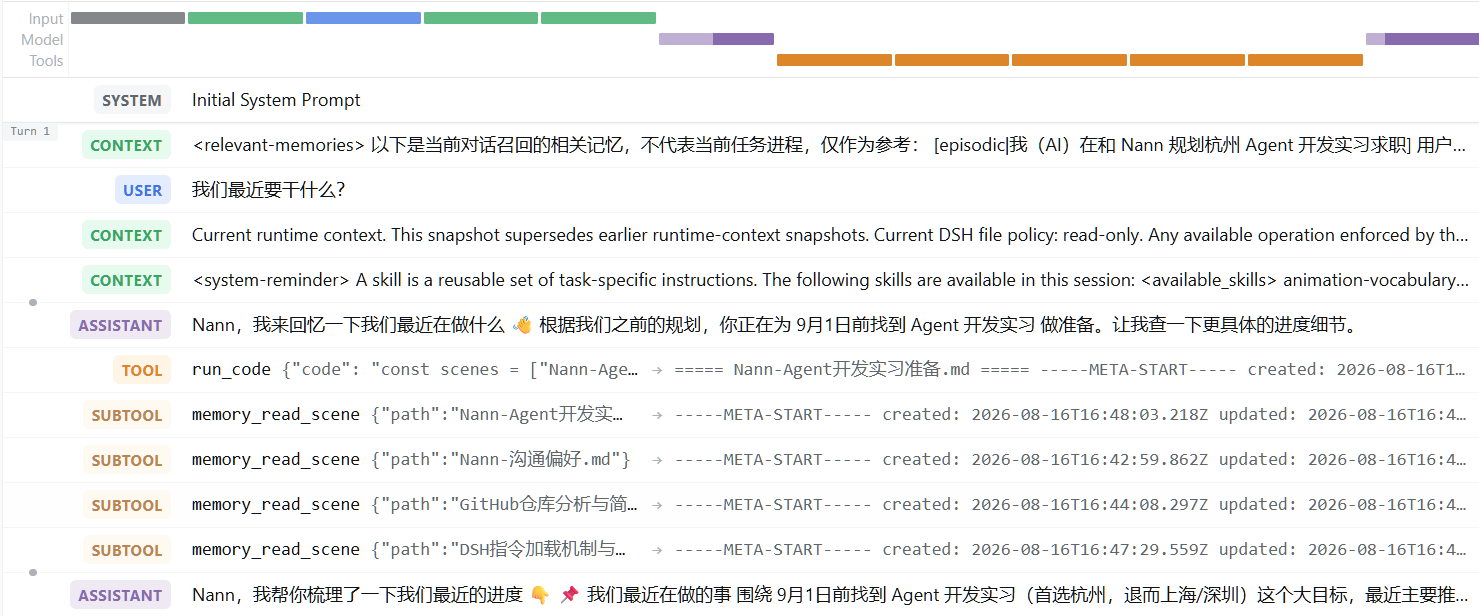
Dans une session restreinte où seule la voie d'exécution de code est ouverte, le modèle passe par `run_code` pour appeler indirectement les outils de mémoire (imbrication SUBTOOL dans la vue des trajectoires) :

<p align="center">
  <img src="./assets/img/ToolTrajectory.png" width="80%"
       alt="Vue de trajectoire des appels d'outils : chronologie colorée en haut et liste d'étapes à gauche (étiquettes colorées SYSTEM/CONTEXT/USER/ASSISTANT/TOOL/SUBTOOL), l'étape de l'outil run_code imbrique 5 appels du sous-outil memory_read_scene (marque SUBTOOL), à droite le panneau de détails de l'étape sélectionnée">
</p>

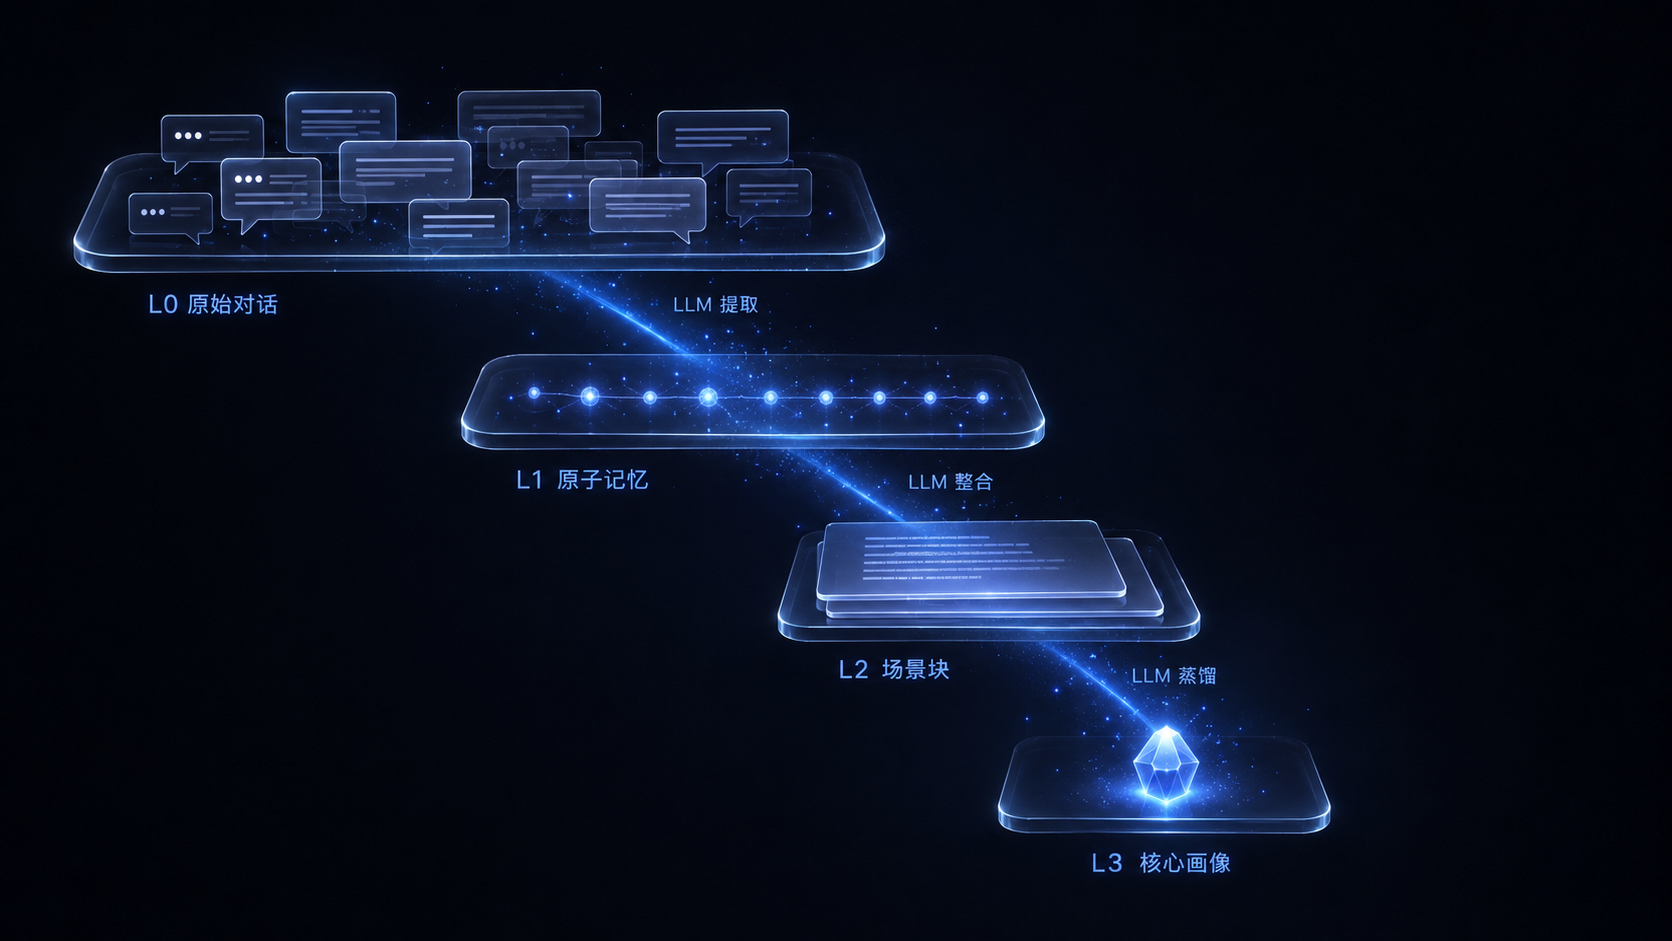
## Mémoire stratifiée (L0–L3)

<p align="center">
  <img src="./assets/img/Layers.png" width="100%"
       alt="Les quatre couches de la mémoire stratifiée (affinage couche par couche, du haut gauche vers le bas droit) : L0 conversations brutes (bulles de dialogue) → L1 mémoires atomiques (particules de faits émissives) → L2 blocs de scène (panneaux documentaires de verre) → L3 profil central (cœur cristallin émissif) ; les couches sont reliées par des faisceaux LLM d'extraction/consolidation/distillation, dont la largeur décroissante traduit l'affinage progressif des données">
</p>

## Modes de mémoire par session

<p align="center">
  <img src="./assets/img/Modes.png" width="100%"
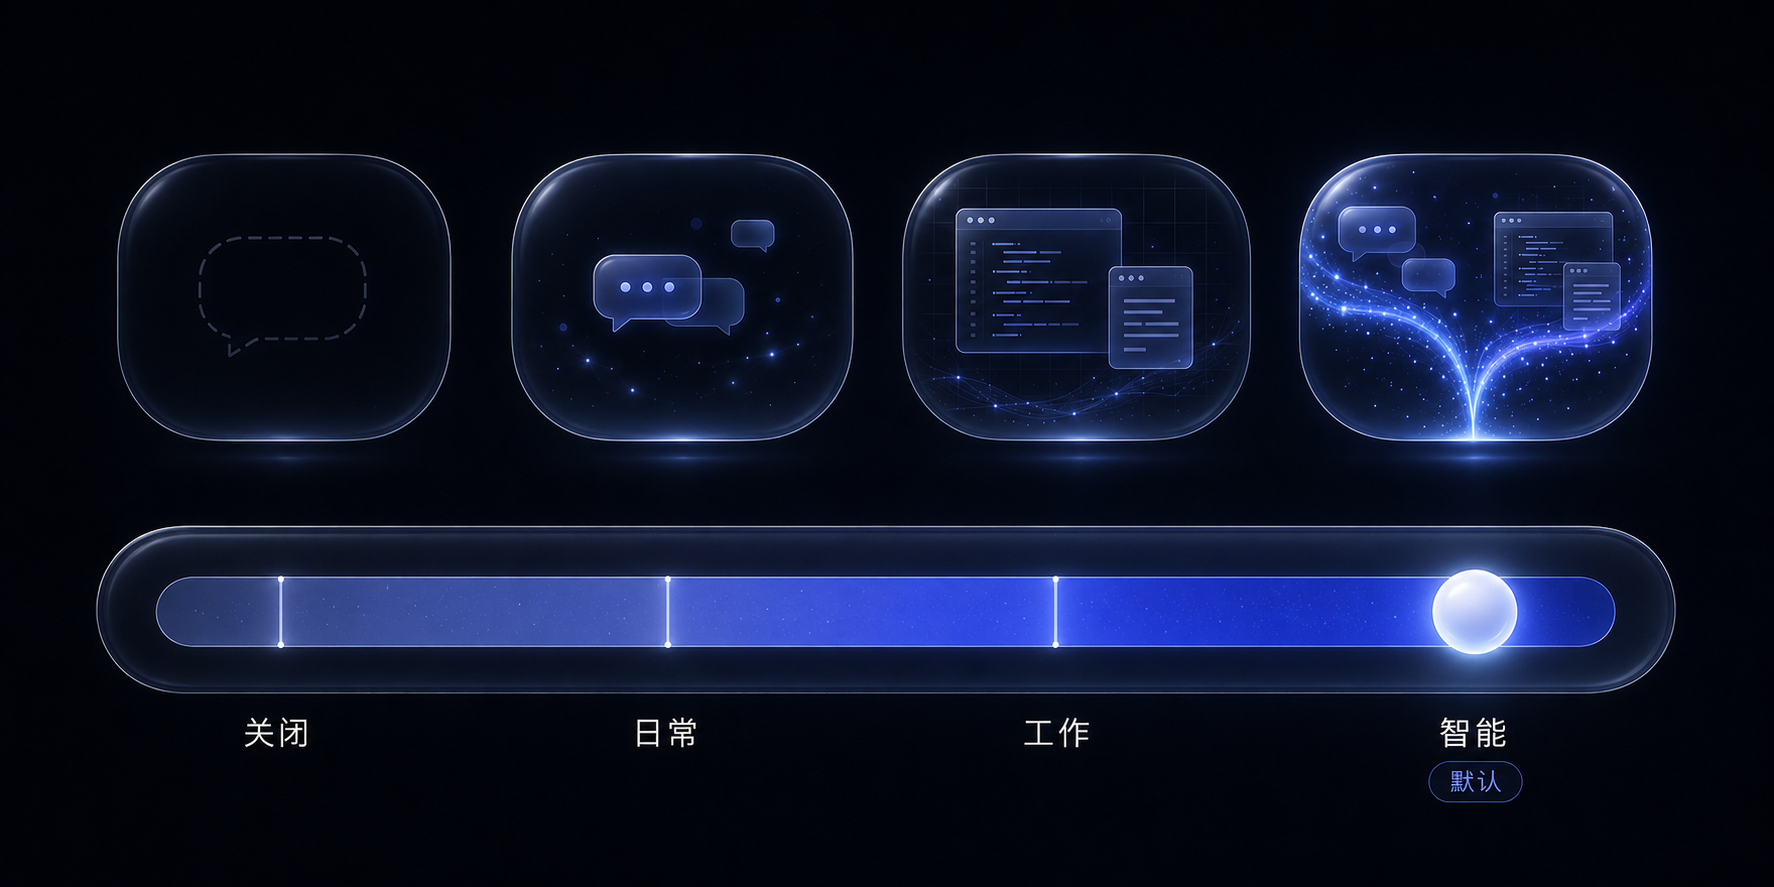
       alt="Modes de mémoire par session : un curseur en capsule de verre à quatre arrêts (日常·工作·智能·关闭 / Quotidien·Travail·Intelligent·Désactivé), la sphère émissive arrêtée sur Intelligent (défaut) ; au-dessus de chaque mode une micro-scène — Quotidien : bulle de conversation personnelle, Travail : panneau de document de code, Intelligent : deux flux convergeant au plus vif de la lumière, Désactivé : bulle fantôme en pointillés assombrie">
</p>

- **Le contrôle** : un pill dans la barre de saisie, à droite du sélecteur de mode (`Mémoire · auto`) ; un clic fait flotter au-dessus le curseur de modes, qui s'adapte aux thèmes clair/sombre ;

- la moitié inférieure du panneau flottant est la **zone d'informations de session** : résultats de rappel (occurrences/tours de recherche et cumul), progression d'accumulation (tranche x de la session / seuil effectif ; le mode Désactivé affiche le nombre de tranches en attente), nombre de mémoires produites dans la session, nombre de messages de la session, plus une ligne d'état anormal (stockage dégradé / recherche vectorielle indisponible) et un résumé global (entrées en attente de distillation, dernière distillation) ;
  les données passent par le point de terminaison `dsh-memory/session-stats` (registre purement en mémoire + COUNT indexé, zéro I/O fichier),
  avec un sondage adaptatif pendant l'ouverture (2 s en activité / 5 s au repos) ; il s'arrête à la fermeture ;

- le choix de chaque session est persisté par sessionId dans `session-modes.json` : rien ne se perd au redémarrage ou à la reprise ;
  il se combine avec l'interrupteur global (le global est le robinet maître) ; L2/L3 sont intégralement cloisonnés par famille, sans fuite de contenu.

- **Écriture sans lecture (#38)** : interrupteur tri-états « Injection » dans le panneau flottant (suivre le global / on / off) — sur « off », la session passe **en écriture seule** : capture et distillation continuent (la conversation alimente normalement L0→L1→L2/L3), mais aucune mémoire n'est injectée dans cette session
  (injection de rappel, zones stables profil/navigation et guide d'outils s'arrêtent ensemble ; les outils de lecture comme `memory_search` renvoient un avis d'écriture seule). La face du pill devient `Mémoire · écriture seule` pour signaler l'état ; le réglage est persisté par session : revenir à
  « suivre le global » l'efface et suit à nouveau l'interrupteur de rappel de la page de paramètres ; idéal pour les sessions de débogage/d'évaluation/sensibles où l'on veut « absorber sans déranger ».
  Orthogonal au mode off : off reste l'invisibilité totale (capture comprise), l'écriture seule garde l'entrée et ferme la sortie.

## Aperçu de l'interface

<p align="center">
  <img src="./assets/img/ui-dark.jpg" width="49.5%"
       alt="Vue d'ensemble du navigateur de mémoires de la page de paramètres en thème sombre : carte d'état (version du plugin, état des interrupteurs capture/distillation/rappel, capacités FTS et vectorielles, nombre de mémoires L1, modèle de distillation) et tuiles de statistiques, contrôles au toucher de verre et accentuation bleu froid">
  <img src="./assets/img/ui-light.jpg" width="49.5%"
       alt="Vue d'ensemble du même navigateur de mémoires de la page de paramètres en thème clair : même mise en page et mêmes informations, fond de cartes clair et même jeu de couleurs d'accentuation, changement de thème sans rechargement">
</p>

## Évaluation mesurée (DSH-MemBench : référence automatisée)

« À quoi ressemblent » les réponses, les images le montrent ; cette section répond avec les chiffres mesurés d'une **référence automatisée** à la question « **à quoi ça sert concrètement une fois activé** » ([`bench/`](./bench/), reproductible en une commande). Méthode : même bibliothèque de scènes, entrées identiques au mot près, **groupe A (mémoire activée) exécuté 3 fois avec fusion des valeurs, groupe B (mémoire désactivée) exécuté 1 fois** (les longues tâches sans mémoire avalent plusieurs fois plus de tokens par scène, d'où ce garde-fou de coût) ; la piste dialogue ne fait tourner que le groupe A (les sessions du groupe B sont indépendantes et sans mémoire : l'échec y est garanti, ce contrôle n'apporte aucune information, il a été retiré). Environnement de la piste dialogue : `deepseek-v4-flash` officiel de DeepSeek, plugin 0.8.5 (juge et candidat de même souche, réponses intégrales archivées pour vérification humaine), Windows ; la conception des épreuves s'inspire de [LongMemEval](https://github.com/xiaowu0162/longmemeval) / [LoCoMo](https://snap-research.github.io/locomo/) / [AMB](https://github.com/vectorize-io/agent-memory-benchmark), les épreuves étendues et la piste cycle de vie de [MemoryAgentBench](https://arxiv.org/abs/2507.05257) / [GoodAI LTM](https://github.com/GoodAI/goodai-ltm-benchmark) / BEAM.

> La piste dialogue constitue la **nouvelle base 0.8.5** (plugin corrigé + barème de notation rectifié) ; les chiffres de la piste workflow restent l'archive 0.8.3 (depuis 0.8.5, la bibliothèque de scènes passe à 8, avec une nouvelle scène de mémoire prospective ; nouvelle exécution à faire).

### Piste dialogue (20 scènes × 10 types d'épreuves × 3 passages = 420 questions) : répond-il juste ?

> Base 0.8.5 (données du groupe A ; le groupe B de la piste dialogue est retiré, seul A tourne).

<p align="center">
  <img src="./assets/readme/bench-dialog.svg" width="100%"
       alt="Graphique de précision de la piste dialogue de DSH-MemBench (groupe A · mémoire activée) : précision globale 95,2 % (400/420) ; les six épreuves centrales à 60 questions chacune — extraction 58/60, multi-sauts 60/60, chronologie 56/60, mise à jour 55/60, souvenir de scène 52/60, refus de répondre 60/60 et 0 invention ; les quatre épreuves étendues à 15 questions chacune — accumulation incrémentale 15/15, mises à jour en chaîne 15/15, ordonnancement d'événements 14/15, reformulation synonymique 15/15">
</p>

**Double voie de rappel** (groupe A) : taux de rappel de l'injection passive de **78,1 %** (les points clés de la question figurent dans l'injection, 281/360) ; pour le reste, le modèle **interroge de lui-même les outils de mémoire** — 106 questions en requête active, **75 questions sauvées par les outils** ; les 95,2 % de bout en bout sont le fruit de la synthèse des deux voies et de leur exploitation par le modèle. Alors que la base de mémoires s'accumulait d'une scène à l'autre, les injections de rappel des sondes ont mélangé 295 fois des mémoires d'autres scènes (comptées honnêtement) et la précision globale est pourtant passée de 92,8 % en début de série à 97,7 % en fin de série — la résistance aux interférences a tenu face à une base de mémoires enflée (hors ligne, en rajoutant 600 enregistrements de bruit synthétique, le recall\@5 de la couche de recherche ne recule que de 2,8 pp).

**Regard par couches sur les points faibles** : indicateurs hors ligne de la couche de recherche (recall\@5, reproduction contrôlée) 73,3 % au total, dont ordonnancement d'événements 0 % et souvenir de scène 50 % — les 93 %+ de bout en bout tiennent à la robustesse du modèle une fois les mémoires voisines injectées ; **triangle d'efficacité** (le coût de la mémoire) : l'injection n'ajoute pas de latence (les tours injectés répondent en moyenne 210 ms plus vite que les tours sans injection), l'injection représente environ 10,3 % de l'entrée par tour, et la chaîne de distillation complète amortit ≈2727 tokens d'entrée / 240 de sortie par message capturé (1172 appels, 0 échec).

### Piste workflow (archive 0.8.3 · version 7 scènes · groupe A 3 fois / groupe B 1 fois, sandbox d'outils réelle) : fait-il juste, fait-il sobre ?

<p align="center">
  <img src="./assets/readme/bench-workflow.svg" width="100%"
       alt="Graphique comparatif A/B de la piste workflow de DSH-MemBench : complétude du segment sonde 59/69 (85,5 %) pour le groupe A contre 10/23 (43,5 %) pour le groupe B ; comparaison des coûts (groupe B = barre de référence pleine, moyenne par scène) — étapes 24,3 contre 41,4 (B +70 %), appels d'outils 37,7 contre 62,1 (B +65 %), tokens d'entrée 266k contre 1,81M (B ×6,8) ; sonde de la scène conventions de style : A 12/12 contre B 0/4 ; tokens d'entrée par scène des longues tâches : A 266k contre B 1,81M">
</p>

**Complétude du segment sonde : 85,5 % contre 43,5 % (+42 pp)** : sur les segments d'enseignement/modification, les deux groupes disposent du contexte sur place ; le segment sonde (reprise de la tâche dans une nouvelle session) est la seule fenêtre de mémoire pure — les trois nouvelles scènes d'épreuve du groupe A (mise à jour d'un savoir-faire / désambiguïsation de jumeaux / poursuite des conventions de style) font toutes 12/12 sans faute et à l'identique sur les trois tours ; le groupe B, sur la sonde de la scène conventions de style, fait **0/4** (les conventions de nommage/structure/séparateur de milliers/pied de page ne vivent que dans la mémoire, la sandbox ne permet pas de les deviner) ; sur la scène de mise à jour de processus, il peut en revanche reconstituer en lisant les scripts (pouvoir discriminant limité par les affordances de la sandbox, signalé honnêtement).

**Coût des longues tâches : le groupe B consomme par scène 6,8 fois plus de tokens d'entrée que le groupe A** (1,81M contre 266k) — sans mémoire, l'agent avance en réexplorant ; en mode de réflexion high, il peut même s'inventer tout un chantier pour sonder un processus qu'une simple convention de script aurait suffi à coder. Tokens de sortie ×3 (46,2k contre 15,4k), étapes +70 %. C'est exactement la valeur centrale de la mémoire : **ce qu'on économise, ce n'est pas la difficulté de la tâche, ce sont les allers-retours inutiles et la réexploration**.

### Méthodologie et reproduction

```bash
node bench/harness/run.mjs --arm A --repeats 3 --provider deepseek-official --model deepseek-v4-flash   # piste dialogue (groupe A seul)
node bench/harness/run.mjs --track workflow --arm AB --repeats 3 ...                                  # piste workflow (groupes A/B en parallèle)
node bench/harness/run.mjs --track lifecycle --arm A ...                                              # piste cycle de vie (gating/off/rebuild/oubli)
node bench/harness/report.mjs --latest [dialog|workflow]                                               # rapport consolidé
node bench/harness/retrieval-metrics.mjs <runDir> --flood 200,600                                     # indicateurs de la couche de recherche + courbe d'inondation
```

- Notation : jugement programmatique `contains-all` + jugement par modèle de notation point par point (texte intégral des réponses et motifs de notation archivés dans `result.json` pour vérification humaine) ; pour les questions avec stale (mise à jour/chaîne/oubli), on ne pénalise que si « l'ancienne valeur est énoncée comme situation actuelle » ; les questions à refus de réponse acceptent de citer le contexte réel pour expliquer « pourquoi on ne sait pas ce qui est demandé » ; la complétude du workflow est validée programmatiquement sur fichiers produits + contenus clés (quatre types de critères : vérifications positives/mots interdits/absence de produit/existence) ;

- Face d'indicateurs : outre la table globale de précision (6 épreuves centrales + 4 étendues), production automatique des **indicateurs hors ligne de la couche de recherche** (recall\@5 / précision d'injection / fuite d'informations périmées), du **triangle d'efficacité** (coût différentiel d'injection / part injectée / comptabilité de distillation amortie par message), de l'**analyse de position à l'échelle** (précision/pollution sous grossissement de la base) et d'une section propre à la piste cycle de vie (matrice de gating par famille / double assertion off / fidélité du rebuild / oubli) ;

- Progression en direct : au lancement d'une référence, un panneau de progression local démarre et le navigateur s'ouvre (`--no-panel` pour désactiver) — progression par scène/étape/message des deux bras A/B, battements de cœur et fraîcheur d'activité (trancher « coincé vs processus mort » d'un coup direct), coût cumulé qui grossit en marchant ;

- Tous les indicateurs proviennent de l'usage remonté par le fournisseur (entrée avec ventilation des hits de cache) et du repli des événements de session ; le taux de cache en régime établi exclut la première requête de chaque session (base 0.8.5 : 89,1 % — l'injection de mémoire ne casse pas le cache) ;

- Usage en régression : un passage avant et après modification du plugin, `compare.mjs` produit la table comparative (en-tête d'environnement vérifié avec gitSha + alerte de dérive du groupe B témoin + comparaison des indicateurs de la couche de recherche) ;

- Limites (déclaration honnête) : machine unique ; groupe A ×3 fusionné, groupe B ×1 (garde-fou de coût, bruit plus fort) ; juge et candidat : même souche pour la base dialogue 0.8.5, hétérogènes pour l'archive workflow (glm-5.3 juge v4-flash) ; bibliothèque de scènes construite par l'auteur (orientée vers les scènes favorables à la mémoire ; libre à vous de reproduire) ; les affordances des fichiers de la sandbox peuvent partiellement divulguer le processus (le groupe B peut lire les scripts pour reconstituer ; les endroits au pouvoir discriminant limité sont signalés honnêtement) ; double niveau d'audit des outils (strict : violation = pénalité / souple : simple alerte), en pratique 0 violation des deux côtés.

Rapport complet et données question par question : [`bench/baseline/`](./bench/baseline/).

## Disposition du stockage

<p align="center">
  <img src="./assets/readme/storage.svg" width="100%"
       alt="Disposition du stockage : architecture à double écriture (JSONL source de vérité en ajout seul + memory.db base de recherche principale) ; formes de fichiers : conversations/records/scenes/persona/state/pending/session-modes/embedding-source/catalogue de modèles/runtime d'inférence/journaux et archives de reconstruction ; trois stratégies de recherche keyword/embedding/hybrid (RRF k=60) ; la chaîne de dégradation garantit de ne jamais bloquer l'hôte">
</p>

La capacité vectorielle est désactivée par défaut (FTS pur). Le `ctx.llm` de DSH n'a pas de point de terminaison embeddings ; la recherche sémantique est fournie par une **source d'embedding à trois états** (désactivée / distante / locale), commutable à chaud depuis la page de paramètres — voir la section suivante.

## Recherche sémantique (source d'embeddings)

La page de paramètres (Mémoire → Aperçu → Recherche sémantique) permet de choisir la source d'embedding, effective immédiatement, sans retoucher la configuration ni redémarrer :

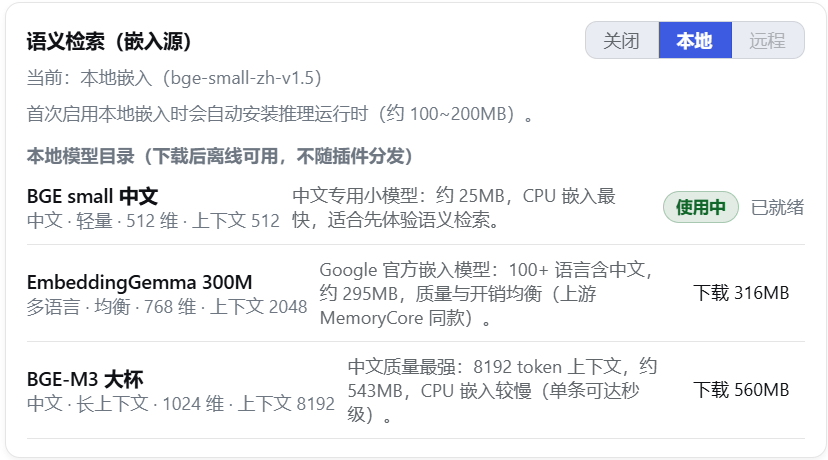
<p align="center">
  <img src="./assets/img/EmbeddingSource.png" width="70%"
       alt="Panneau de recherche sémantique (source d'embedding) de la page de paramètres (thème clair) : sélecteur à trois états (Désactivé/Local/Distant, Local sélectionné) affichant la source d'embedding actuelle et l'avis d'installation automatique du runtime au premier passage en local ; en dessous, le catalogue de modèles locaux liste BGE small chinois (en usage/prêt), EmbeddingGemma 300M (316 Mo à télécharger) et BGE-M3 (560 Mo à télécharger) avec dimensions/contexte/taille/particularités et entrées de téléchargement">
</p>

Trois sources d'embedding : **désactivée** (défaut, recherche par mots-clés BM25 pure), **distante** (apportez n'importe quel service `/embeddings` compatible OpenAI, les quatre clés `embedding.*` doivent être complètes pour être sélectionnable), **locale** (choisissez un modèle du catalogue intégré, inférence **CPU** ONNX quantifiée — sans clé API, les données ne quittent pas la machine). Le catalogue local est une liste blanche embarquée dans le plugin (révision verrouillée + sha256 par fichier ; impossible d'y télécharger un dépôt quelconque).

- **Téléchargement** : téléchargement en un clic depuis la carte du modèle (miroir par défaut `hf-mirror.com`, reprise après interruption + contrôle d'intégrité sha256 ; si le direct est inaccessible, on peut passer par un proxy — détection automatique par défaut des variables d'environnement `HTTPS_PROXY`/`ALL_PROXY` etc., voir `embedding.proxy`). En cas d'échec d'un fichier, nouvelle tentative automatique avec changement de clé de cache (`?dshmem-retry=N`, pour contourner les objets de cache corrompus que le CDN du miroir sert parfois) ; en cas de sha256 non conforme, on retélécharge de zéro ; en cas d'erreur réseau, la reprise après interruption est conservée ; les données atterrissent dans `models/<id>/` du répertoire de données, supprimables à tout moment depuis la page de paramètres ;

- **Runtime à la demande** : le runtime d'inférence (transformers.js, environ 100~200 Mo) n'est installé qu'au premier passage en mode local, dans le répertoire de données `runtime/` — hors de l'arbre de dépendances du plugin, sans toucher à son répertoire d'installation ; chargement du modèle et inférence s'exécutent dans un **thread worker séparé**, sans geler la boucle d'événements de l'hôte (conversation et interactions de pages restent normales pendant le calcul des embeddings) ;

- **Bascule à chaud** : changer de source en un clic — ré-embedding intégral automatique en arrière-plan (progression visible, annulable ; pendant ce temps, la recherche retombe automatiquement sur les mots-clés, sans affecter la conversation ; si la dimension change, la table vectorielle est reconstruite à la nouvelle dimension) ; en cas d'échec, l'ancienne source est conservée et, au redémarrage, c'est bien l'ancienne source qui repart ;

- **Règle d'effet = plafond de déploiement AND choix au runtime** : `embedding.allowLocalModels=false` désactive le mode local en bloc, et sans les quatre clés `embedding.*` le mode distant n'est pas sélectionnable (verrouillage possible en déploiement d'entreprise) ; l'état est persisté dans `embedding-source.json`.

## Configuration

Les réglages par-dessus les valeurs par défaut s'écrivent dans le `cordis.patch.yml` du profil lui-même, sous forme d'**entrées patch nues au premier niveau** (`id:` direct, sans les envelopper dans un `insert:` — ajouter par `insert:` une entrée de même id que la couche bundle provoque un échec de démarrage `duplicate loader entry id`) :

```yaml
- id: dsh-memory
  name: dsh-prime-memory
  config:                    # les clés remplacent la ligne entière (pas de fusion profonde) ; écrivez toutes les clés à conserver
    family: auto             # mode par défaut des nouvelles sessions : auto | chat | work
    llm:                     # routage statique du modèle de distillation (les deux champs remplis = pin de déploiement, prioritaire sur la
      provider: ''           # chaîne de routage de la page de paramètres ; vide = suivre la route principale de la page de paramètres ou le modèle par défaut actuel)
      model: ''
```

| Champ | Défaut | Description |
| ---------------------------- | ----------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `family`                     | `auto`                  | Mode de mémoire par défaut des nouvelles sessions : `auto` (double famille automatique) \| `chat` (personnel) \| `work` (travail) ; commutation temporaire dans la session via le contrôle de la barre de saisie |
| `dataDir`                    | `$DSH_HOME/memory`      | Répertoire de données |
| `capture.enabled`            | `true`                  | Capture L0 |
| `capture.stripCodeBlocks`    | `true`                  | Retirer les blocs de code des messages de l'assistant |
| `capture.maxMessageChars`    | `4000`                  | Nombre maximal de caractères par message |
| `capture.redactSecrets`      | `true`                  | Expurgation des charges utiles : dès l'écriture de capture, remplace 8 classes de secrets (PEM/Bearer/JWT/Cookie/clés API de fournisseurs/e-mails/longs numéros/ID à haute entropie) par des espaces réservés `[REDACTED:<KIND>]`, couvrant L0, les entrées de distillation et les écritures manuelles ; `false` rétablit le texte en clair (une fois activé, le texte L0 d'origine devient irrécupérable) |
| `trace.enabled`              | `true`                  | Traçage structuré : événements de rappel/distillation en JSONL quotidien (`<dataDir>/trace/`), consultable et commutable dans l'onglet « Journaux » de la page de paramètres |
| `trace.retentionDays`        | `14`                    | Conservation des événements de trace en jours (`0` = illimité) |
| `trace.captureContent`       | `false`                 | Ne stocke le texte intégral des requêtes de rappel que si `true` (défaut : longueur + sha256 seulement) |
| `extract.enabled`            | `true`                  | Extraction L1 |
| `extract.minMessages`        | `6`                     | Seuil en régime établi : dès que N nouveaux messages s'accumulent dans une session, lance une extraction L1. En phase de démarrage, le seuil effectif grimpe de 1 en doublant jusqu'à cette valeur (mémoire dès le premier tour, puis accumulation automatique pour économiser des appels) |
| `extract.idleSeconds`        | `300`                   | Filet d'inactivité : après N secondes de silence de la session, enregistre les tranches non distillées (rattrape « l'utilisateur parti avant d'atteindre le seuil ») ; `0` désactive |
| `extract.backgroundMessages` | `10`                    | Nombre de messages de contexte joints à l'extraction (interrogés à la volée dans L0 pour la session en question, sans contamination entre sessions) |
| `extract.candidatePool`      | `5`                     | Taille du bassin de candidats de déduplication |
| `extract.intraBatchDedupe`   | `true`                  | Déduplication intra-lot (même tour/session) : normalisation + regroupement vectoriel (même famille/type) avant l'appel LLM, pour que les fragments d'une conversation ne soient pas fusionnés en une seule mémoire longue (réduit le nombre et la durée, pas le pic par inférence) |
| `l2.enabled`                 | `true`                  | Consolidation de scènes L2 |
| `l2.minNewMemories`          | `5`                     | Seuil de nouvelles mémoires depuis la dernière consolidation L2 |
| `l2.maxScenes`               | `12`                    | Nombre maximal de blocs de scène |
| `l2.sceneContextLimit`       | `3`                     | Nombre maximal de scènes similaires jointes en texte intégral au prompt L2 |
| `l3.enabled`                 | `true`                  | Distillation du profil L3 |
| `l3.interval`                | `20`                    | Intervalle de distillation L3 (en nouvelles mémoires) |
| `recall.enabled`             | `true`                  | Rappel automatique |
| `recall.maxResults`          | `5`                     | Nombre maximal d'entrées L1 injectées avant chaque nouveau message utilisateur |
| `recall.maxCharsPerMemory`   | `500`                   | Limite de caractères par mémoire injectée (troncature au-delà, avec invitation à interroger le texte complet via l'outil mémoire) ; `0` = illimité |
| `recall.maxTotalRecallChars` | `2000`                  | Limite totale de caractères injectés par tour (au-delà, on abandonne la queue selon la pertinence) ; `0` = illimité |
| `recall.timeoutMs`           | `5000`                  | Budget total du rappel (ms) : en cas de dépassement, le tour d'injection est sauté sans bloquer la conversation ; `0` = sans limite de temps |
| `recall.includePersona`      | `true`                  | Injecte le contexte de profil dans le prompt système (`<user-persona>`, zone stable) |
| `recall.includeSceneNav`     | `true`                  | Injecte la navigation de scènes dans le prompt système (`<scene-navigation>`, zone stable) |
| `recall.strategy`            | `hybrid`                | Stratégie de recherche : `keyword` / `embedding` / `hybrid` |
| `recall.scoreThreshold`      | `0.3`                   | Seuil de score de rappel (en dessous, pas d'injection ; effectif uniquement pour les stratégies keyword/embedding, hybrid ne filtre pas avant fusion ; le chemin outil ne filtre pas) |
| `recall.decayHalfLifeDays`   | `30`                    | Demi-vie de décroissance temporelle du rappel (jours, 0 = désactivé) : le tri pondère doucement selon `pertinence × max(0.5, 0.5^(jours depuis la mise à jour/demi-vie))` — entre candidats de pertinence proche, les mémoires fraîches passent d'abord (rotation des places), une vieille mémoire perd au plus la moitié de son score de tri (plancher de sûreté : les faits de long terme ne coulent pas au fond) |
| `embedding.enabled`          | `false`                 | Interrupteur de la recherche vectorielle ; désactivé, fonctionne en FTS pur |
| `embedding.baseUrl`          | vide                    | Adresse d'un service /embeddings compatible OpenAI (ex. `https://api.siliconflow.cn/v1`) |
| `embedding.apiKey`           | vide                    | Clé API |
| `embedding.model`            | vide                    | Nom du modèle d'embedding |
| `embedding.dimensions`       | `0`                     | Dimension des vecteurs (obligatoire si activé, doit correspondre à la sortie du modèle) |
| `embedding.maxInputChars`    | `5000`                  | Nombre maximal de caractères par texte (troncature au-delà) |
| `embedding.maxInputTokens`   | `0`                     | Budget de **jetons** par texte pour l'intégration locale : `0` (défaut) = min(fenêtre du modèle, plafond 1536) ; >0 = explicite, réduit avec un warn s'il dépasse. Ce n'est pas la même limite que la ligne au-dessus : celle en caractères ne borne que le mode distant et la taille IPC, la protection locale doit être en jetons (#22) |
| `embedding.respawnOnCrash`   | `true`                  | Si le sous-processus d'intégration locale **se réauto-répare de façon bornée** après un plantage brutal (#22) : défaut activé — re-fork + re-chauffe ≤2 fois par fenêtre de 60 s, les lots reprennent une fois depuis le point de contrôle en direct (les vecteurs d'en-tête perdus avec l'enfant tué sont rattrapés par le backfill) ; désactivé = comportement antérieur (un plantage bloque jusqu'au redémarrage / changement de source). Revoque délibérément la note 0.26.25 « pas d'auto-réparation ». Trois couches = garde-fou(1536) / baisse du pic(memPattern) / auto-réparation(respawn). |
| `embedding.timeoutMs`        | `10000`                 | Délai maximal d'un appel d'embedding (ms) |
| `embedding.allowLocalModels` | `true`                  | Autorise le mode embedding local (plafond de déploiement : désactivé, la page de paramètres ne peut plus télécharger de modèles ni passer en local) |
| `embedding.mirror`           | `https://hf-mirror.com` | Racine du miroir de téléchargement des modèles locaux (ramenérable à l'officiel `https://huggingface.co`) |
| `embedding.proxy`            | `''`                    | Proxy de téléchargement des modèles, trois états : `''` (défaut) = détection automatique des variables d'environnement de proxy (`HTTPS_PROXY`/`ALL_PROXY` etc., en respectant `NO_PROXY`) ; `none` = désactivation, connexion directe forcée ; autre valeur = URL du proxy (ex. `http://127.0.0.1:7890`). Le miroir en direct est par intermittence inaccessible depuis les réseaux chinois (alternance de timeouts directs et d'octets pollués) ; sur une machine disposant d'un proxy, gardez la détection automatique par défaut |
| `llm.provider/model`         | vide                    | Routage statique du modèle de distillation (pin de déploiement) : quand provider et model sont **tous deux renseignés**, le routage de distillation est verrouillé, prioritaire sur la chaîne de routage runtime de la page de paramètres et sur le modèle par défaut (le déploiement peut forcer la distillation sur une route donnée) ; vide = suivre « route principale de la chaîne de routage de la page de paramètres → modèle par défaut ». Au runtime, l'**éditeur de chaîne de routage de distillation** (page de paramètres → Mémoire → Aperçu → Paramètres de distillation) permet de configurer la route principale et la chaîne de repli (à choisir parmi les **fournisseurs configurés** (y compris les fournisseurs personnalisés ajoutés dans dsh → Paramètres → Modèles) ; la ligne de route principale peut rester vide pour suivre le modèle par défaut) ; dès qu'il est non vide, il prend le contrôle intégral de cette configuration statique, effet immédiat sans redémarrage |
| `llm.fallbacks`              | `[]`                    | Chaîne de repli de distillation : liste de routes de secours essayées l'une après l'autre, dans l'ordre des entrées, quand la route principale échoue (erreur/coupure/erreur réseau/**sortie vide**) ; entrée = `{provider, model, reasoningEffort?}` (un niveau non vide écrase le `llm.reasoningEffort` global, toujours borné par les capacités du modèle) ; les entrées identiques à la route principale sont sautées automatiquement ; **chaque route dispose de l'intégralité de** **`timeoutMs`** ; en cas d'échec total, on repart vers le mécanisme existant de reprise avec back-off par session. Tableau vide (défaut) = comportement mono-route inchangé (voir ci-dessous [Chaîne de repli de distillation et modèles à TTFT lent](#chaîne-de-repli-de-distillation-et-modèles-à-ttft-lent)) ; quand la chaîne de routage runtime de la page de paramètres (`distillChain`) est non vide, elle prend **le contrôle intégral** de la route principale et de la chaîne de repli (chaîne à une ligne = pas de repli explicite) ; vide = suivre cette configuration |
| `llm.layerRoutes`            | `{}`                    | **Routage par couche** de la distillation : chaque clé de couche `l1`/`l2`/`l3` reçoit une **chaîne complète** (entrées identiques à `llm.fallbacks`, **la ligne de tête doit porter provider+model explicites**) ; non vide, elle **remplace intégralement** la résolution de cette couche (route principale et repli de la couche relèvent de la chaîne de couche, la chaîne globale n'y participe plus) ; vide/absent = la couche suit le global ; `l1` couvre à la fois les points d'appel extraction+déduplication. Au runtime, on peut éditer couche par couche dans le panneau par segments « Paramètres de distillation » de la page de paramètres (prioritaire sur cette configuration statique) ; le pin de déploiement n'abroge pas les chaînes de couche statiques (toutes deux sont de la configuration de déploiement, même précédent que la chaîne de repli). Orthogonale et composable avec la chaîne de repli — une chaîne par couche (ADR-0005) |
| `llm.maxTokens`              | `65536`                 | Vanne de sortie globale de secours pour les appels non couches. Chaque couche de distillation a son propre budget (extraction 16k / dédup 8k / L2 32k / L3 16k ; ×4 automatique en niveau de réflexion high/xhigh/max, pour éviter que le reasoning n'épuise le budget) ; les budgets par couche sont ajustables au runtime (page de paramètres → Mémoire → Aperçu → Paramètres de distillation ; vide/0 = suivre les défauts intégrés) |
| `llm.reasoningEffort`        | vide                    | Niveau de réflexion de la distillation : chaîne vide = **auto** (résolu selon les capacités du modèle : niveau par défaut du modèle → `high`) ; une valeur explicite (`off`/`none`/`minimal`/`low`/`medium`/`high`/`xhigh`/`max`) n'est envoyée que si le modèle déclare la supporter — les vocabulaires d'effort diffèrent d'un fournisseur à l'autre (deepseek accepte `off`, la famille OpenAI dit `none`, les modèles sans niveau déclaré ne reçoivent rien), un niveau non supporté est automatiquement rétrogradé en « rien envoyer » avec une seule alerte ; en niveau high/xhigh/max, le budget de sortie est ×4 automatiquement. Au runtime, l'éditeur de chaîne de routage permet de surcharger le niveau **route par route** (menu déroulant en ligne, vocabulaire affiché en direct selon les capacités déclarées de chaque modèle, défaut : suivre cette valeur) |
| `llm.temperature`            | `0.3`                   | Température de distillation |
| `llm.maxInputChars`          | `700000`                | Budget de caractères d'entrée par appel de distillation (les entrées L1 excédentaires sont automatiquement extraites par blocs) ; ajustable au runtime (page de paramètres → Paramètres de distillation → Budget d'entrée ; vide/0 = suivre cette valeur) |
| `llm.timeoutMs`              | `120000`                | Délai maximal d'un appel de distillation (ms) |
| `tokenCost.retentionDays`    | `365`                   | Conservation en jours du détail des coûts de distillation (table token\_cost), avec nettoyage glissant des lignes plus anciennes à l'écriture ; `0` = conservation illimitée. La borne de la fenêtre « N derniers jours » du tableau des coûts est la même |
| `tools`                      | `true`                  | Faut-il enregistrer les outils de mémoire appelables par le modèle |
| `benchControl`               | `false`                 | Enregistre le service de contrôle bench (déclenchement de rebuild intra-processus / réglage des modes de session / instantané d'usage de distillation, pour la piste lifecycle de la référence). Désactivé par défaut — surface nulle en déploiement de production, n'activez pas à la légère |
| `scope` | `global` | **Périmètre de stockage** (visibilité) : `global` (défaut) = visible entre les espaces de travail ; `workspace` = cloisonnement par espace de travail de la **famille `work`**. Orthogonal à `family` (type de contenu) — les deux axes répondent à des questions différentes, les quatre quadrants existent (`chat×global` / `chat×workspace` / `work×global` / `work×workspace`). La famille `chat` reste globale par défaut : les mémoires personnelles ont vocation à traverser les projets. **Avec le défaut `global`, le comportement est identique au mot près à l'avant de l'introduction de cette clé** — toutes les données monoracine existantes sont rattachées à `global`, la migration ne fait qu'étiqueter l'appartenance, sans déplacer ni supprimer ([ADR-0008](./docs/adr/0008-storage-scope-vs-family.md) / [ADR-0009](./docs/adr/0009-workspace-identity-source.md)). Si l'espace de travail de la session est inconnu, on retombe sur `global` (sans lever d'erreur, sans bloquer) |
| `conflictFreeze.enabled`     | `false`                 | Interrupteur général du **gel des contradictions**. Une fois activé, le vocabulaire de décision de déduplication gagne l'action `conflict` : quand le LLM juge que « les deux versions semblent correctes et que la machine ne peut trancher », il **ne fait plus de `update` automatique ni de `merge`**, mais **parque** la paire dans une file d'attente d'arbitrage — la nouvelle mémoire entre normalement en base, **le contenu des deux parties reste intact**, et le nouvel outil `memory_resolve_conflict` soumet l'arbitrage à l'humain. Désactivé, le prompt de déduplication est **identique au mot près** à celui d'avant la fonctionnalité (zéro dérive). Désactivé par défaut : le gel consomme de l'attention humaine, il ne peut pas être activé pour tout le monde par défaut ([ADR-0010](./docs/adr/0010-conflict-freeze-default-off-and-timeout.md)) |
| `conflictFreeze.maxPending`  | `100`                   | Taille maximale de la file d'arbitrage. Quand le nombre d'affaires en attente atteint la limite, les nouveaux conflits **ne sont plus parqués** et sont soldés sur place selon le winner/loser donné par le LLM (la paire **reste tout de même consignée dans la file**, avec `resolution` noté `auto` pour la distinguer d'une conclusion humaine). La sémantique est « **ne plus en accepter** », pas « supprimer furtivement les anciennes » — c'est de là que vient la bornage, sans perdre les demandes d'arbitrage que personne n'a encore vues |
| `conflictFreeze.timeoutDays` | `30`                    | Dégradation par expiration (jours) : les paires en attente depuis plus de ce nombre de jours sont soldées automatiquement **au début du tour de distillation suivant** (comme ci-dessus, consignées avec `resolution=auto`). `0` = **pas** de dégradation par expiration (désactivation explicite, et non « expiration immédiate de tout le monde »). Sans soupape de sûreté, « deux mémoires contradictoires rappelées côte à côte » resterait dans la base pour toujours |

### Chaîne de repli de distillation et modèles à TTFT lent

Chez certains fournisseurs d'inférence, les offres gratuites/lentes affichent un **délai au premier token (TTFT) pouvant dépasser 20 secondes**, tandis que certains passerelles amont coupent après environ 20 secondes de silence de connexion — les appels de distillation échouent alors de façon fixe à ~20 s (`llm aborted`) et le délai de 120 s du plugin n'a jamais le temps d'entrer en jeu (scénario observé dans le [#31](https://github.com/drscrewdriver/dsh-prime-memory/issues/31)). Trois niveaux d'atténuation, à prendre selon le besoin :

1. **Changer de route** (le plus direct) : page de paramètres → Mémoire → Aperçu → Paramètres de distillation, l'éditeur de chaîne de routage permet de changer la route principale à chaud (ou de placer une route rapide en tête de chaîne), ou de pinner statiquement `llm.provider`/`llm.model`.

2. **Chaîne de repli** (dégradation automatique) : quand la route principale échoue, les routes de secours prennent le relais dans l'ordre, sans intervention humaine :

   ```yaml
   llm:
     provider: opencode-go          # route principale (on peut aussi ne pas pinner et suivre la route principale de la page de paramètres / le modèle par défaut)
     model: ox-alpha-free
     fallbacks:                     # l'ordre des entrées = priorité de dégradation ; sans cette clé, comportement mono-route inchangé
       - provider: opencode-go
         model: deepseek-v4-flash
         reasoningEffort: low       # optionnel : surcharge de niveau pour cette route (défaut : suivre le global)
       - provider: deepseek-official
         model: deepseek-v4-flash
   ```

3. **Routage par couche** (une voie par couche) : les couches de distillation n'ont pas les mêmes exigences vis-à-vis du modèle (L1, très fréquent, veut être bon marché, rapide et stable ;
   L3, rare, tolère un premier paquet lent mais exige de fortes capacités) — on peut doter chaque couche concernée de sa propre chaîne : **une chaîne de repli complète par couche**,
   les couches non configurées continuant d'emprunter la chaîne globale :

   ```yaml
   llm:
     layerRoutes:                  # routage indépendant par couche (#34) ; la ligne de tête doit porter provider+model explicites
       l1:                         # l1 couvre à la fois extraction + déduplication : une chaîne bon marché, rapide et stable
         - provider: opencode-go
           model: deepseek-v4-flash
           reasoningEffort: low
         - provider: deepseek-official   # repli intra-couche : une panne de L1 ne rétrograde que jusqu'ici, pas vers la chaîne globale
           model: deepseek-v4-flash
       l3:                         # distillation du profil L3 : entrées volumineuses à basse fréquence, une chaîne à fortes capacités
         - provider: deepseek-official
           model: deepseek-v4-flash
           reasoningEffort: high
   ```

   On peut aussi éditer couche par couche au runtime dans le **panneau par segments** (global / L1 / L2 / L3)
   de la page de paramètres → Mémoire → Aperçu → Paramètres de distillation ; priorité intra-couche :
   chaîne de couche runtime > chaîne de couche statique de ce YAML > chaîne globale par défaut,
   avec repli niveau par niveau.

   Échec = erreur / coupure / erreur réseau / **sortie vide** (le flux se termine normalement mais avec 0 caractère — pour la distillation, c'est forcément fichu au stade de l'analyse, on reclasse donc en échec de cette route plutôt que de renvoyer une chaîne vide) ; une annulation volontaire de l'appelant ne déclenche pas de dégradation ; chaque route dispose de l'intégralité de `llm.timeoutMs` (un budget partagé donnerait à une route de repli lente au premier paquet une fenêtre inférieure à son véritable temps de premier paquet, rendant la chaîne de repli illusoire) ; le coût en tokens est comptabilisé à chaque tentative (les tentatives échouées aussi, avec les tokens reçus avant la coupure de flux), et l'appel réussi est attribué à la route qui l'a réellement servi. La chaîne de routage se règle aussi à chaud dans l'éditeur « Chaîne de routage de distillation » (page de paramètres → Mémoire → Aperçu → Paramètres de distillation, sans toucher à la configuration ni redémarrer) ; ce YAML convient au déploiement qui veut figer une chaîne statique.

4. **Monter le délai d'attente** : `llm.timeoutMs` ne sert que si la route est réellement lente sans que la passerelle coupe ; quand la passerelle coupe à 20 s, augmenter le délai du plugin est inutile — utilisez les deux premiers niveaux.

## Journaux et diagnostic

L'hôte dsh écrit les journaux du plugin sur la console ; le plugin y ajoute un miroir de niveau info et plus dans `memory.log` du répertoire de données.
Chemin de journal typique d'un tour de conversation : `L0 捕获` → `L0 落盘` → `蒸馏管线开始` → `LLM 调用（输入/输出 字符数、耗时）` → `L1 阶段完成` → `管线结束` ; le tour suivant commence par `召回注入 N 条 L1`. Une sortie vide du LLM
s'accompagne d'un diagnostic complet (finish reason / comptage de tokens / extrait du reasoning) ; un échec d'analyse JSON journalise les 400 premiers caractères
de la sortie brute du modèle ; tous les échecs alertent avec la première frame de la pile. La source de vérité JSONL est ajoutée tour par tour et s'appuie sur le write-back de l'OS (pas de
fsync ligne à ligne) : une coupure de courant ou un crash extrême peut perdre au plus une petite queue de fin ; la base de recherche peut être réimportée intégralement depuis la source de vérité via « Reconstruire la mémoire ».

## Différences avec MemoryCore

- Pipeline complet embarqué (sans dépendre d'une passerelle externe), la distillation réutilise le LLM de DSH lui-même ;

- L2/L3 passent de « l'outil LLM manipule des fichiers » à « le LLM produit un JSON d'opérations / un document complet, exécuté côté ingénierie » ;

- Le point d'injection du rappel est `agent/pre-step` (message synthétique côté messages, sémantique de remplacement du pre-step officiel) + `systemPrompt.context` de scope agent (zones stables profil/navigation, événements/services natifs de DSH) ;

- Stockage/recherche : version monoposte élaguée du backend sqlite officiel (sans colonnes d'isolation multi-locataires, backend cloud TCVDB ni tables d'audit ;
  la tokenisation est identique à l'officielle avec jieba — binaire précompilé @node-rs/jieba + union avec les bigrammes CJK,
  les tokens alimentant les hits de mots entiers exacts de BM25 et les bigrammes préservant le rappel des sous-mots ; en cas d'échec de chargement, repli automatique sur les seuls bigrammes,
  l'index FTS se reconstruit automatiquement selon l'estampille de version du tokenizer).

## Retrait des mémoires, restauration et nettoyage

La suppression se décline en **deux niveaux**, dictés par leur coût : **le niveau réversible est le défaut**, le niveau irréversible exige une demande explicite et embarque son propre export.

| Action | Point de terminaison / outil | Réversible | Description |
| --- | --- | --- | --- |
| Retrait (suppression logique) | `memory_delete` · `dsh-memory/records-delete` | ✅ | Conserve la ligne de la table principale + clôture `valid_to` + écrit un marqueur de remplacement, en retirant seulement les lignes FTS/vecteur. **Par défaut, on ne retire qu'1 entrée** ; pour un lot, passez des `ids` exacts, ne vous fiez pas au matching sémantique |
| Restauration | `dsh-memory/records-restore` | — | Efface le marqueur de retrait + reconstruit les index : l'enregistrement revient dans le rappel |
| Nettoyage physique | `dsh-memory/cleanup-retired` | ❌ | **Seule action irréversible** du plugin. **À blanc par défaut** (omettre `dryRun` équivaut à ne rien supprimer) ; même en exécution explicite, un instantané intégral de la base est d'abord pris et **vérifié par hachage de contenu** — en cas d'écart, arrêt et aucune suppression |
| Liste des instantanés | `dsh-memory/snapshots-list` | — | Liste les instantanés de `snapshots/` dotés d'un manifeste valide (avec motif et nombre d'entrées) |
| Réinjection depuis un instantané | `dsh-memory/snapshot-restore` | — | Réécrit les enregistrements nettoyés. **À blanc par défaut** ; n'accepte que des noms de répertoires d'instantanés, pas de chemins |

Les trois voies de retrait — condamnation à l'arbitrage, remplacement par déduplication (`update`/`merge`), suppression manuelle — **partagent le même primitif** : « supprimer » y garde la même sémantique, tout est récupérable.

### Comment est constitué le « droit à l'erreur » du nettoyage

Avant toute suppression physique, un instantané doit être pris et vérifié (voir table ci-dessus). Le chemin du retour est :

1. `dsh-memory/snapshots-list` — obtenir le nom du répertoire d'instantané (de la forme `l1-<horodatage>-<motif>`) ;
2. `dsh-memory/snapshot-restore` — d'abord à blanc pour voir `missing` (le nombre réellement récupérable, et non le total de l'instantané), puis réécrire avec `dryRun:false` explicite.

L'entrée de restauration **n'accepte que des noms de répertoires, jamais de chemins** : sinon ce RPC vaudrait par surcroît « lire n'importe quel répertoire et écrire son contenu dans la base de recherche ». La restauration elle-même est un upsert idempotent, relançable sans risque.

> **Une sémantique à connaître absolument** : `cleanup-retired` ne nettoie que les enregistrements **déjà retirés**, et l'instantané est pris **avant** la suppression — donc chaque entrée récupérable depuis un instantané de nettoyage porte le marqueur de retrait. Par défaut, `snapshot-restore` ne fait que réécrire les lignes dans la table principale (et déclare honnêtement les `stillRetired`) : **« être revenu dans la table principale » ≠ « être revenu dans le rappel »** ; pour un véritable rollback en une étape, ajoutez `unretire: true`, ou appelez ensuite `records-restore` sur ce lot d'ids.

## Feuille de route

Fonctionnalités planifiées — n'hésitez pas à faire remonter besoins et priorités dans les [Issues](https://github.com/drscrewdriver/dsh-prime-memory/issues) :

- [ ] **Sensibilité aux branches git** : associer les mémoires à la branche git courante, filtrer/pondérer le rappel par branche (orthogonal aux modes de mémoire existants)

- [ ] **Import des mémoires Claude Code / Codex** : migration en un clic des actifs de mémoire existants (`CLAUDE.md`, fichiers de mémoire Claude Code, `AGENTS.md` de Codex etc.) ; une fois importées, elles entrent dans le pipeline de distillation stratifiée

## Remerciements

Le parent direct de ce dépôt est [JunNanLYS/dsh-layered-memory](https://github.com/JunNanLYS/dsh-layered-memory)
— le plugin de mémoire à distillation stratifiée côté DSH. Merci à l'auteur original **JunNanLYS** d'avoir ouvert ce projet : ce dépôt en a réécrit la couche d'implémentation
(son premier commit `0b506b8` est déjà « nettoyage de réécriture en chambre blanche — suppression de l'ancienne implémentation et des artefacts de build ») ; documentation, images et architecture de modules reprennent l'amont.
Par rapport à l'amont, ce dépôt ajoute 12 outils de mémoire orientés agent (dont les écritures à haut privilège `memory_add` / `memory_delete` /
`memory_import`, la série anti-rumination `memory_ruminate`, le graphe de mémoires `memory_search_graph` /
`memory_expand_graph_node`, la traçabilité des décisions `memory_receipts`, l'arbitrage des contradictions `memory_resolve_conflict`),
le transport de mémoires entre outils `skills/memport`, ainsi que la déclaration des captures d'écran pour la boutique.

Deux de ces outils servent la **traçabilité** :

- `memory_receipts` — retrace « **d'où vient** cette mémoire ». Chaque décision de déduplication L1 laisse un reçu
  (**résumé du bassin de candidats vu à la décision** + conclusion) ; on peut demander d'un enregistrement « de quel tour il vient et quel bassin était visible alors »,
  ou demander d'un lot « ce qui a été jugé pendant ce tour ». Le reçu doit exister **avant** l'événement — l'instantané d'entrée ne peut pas être reconstitué après coup
  ([ADR-0006](./docs/adr/0006-l1-decision-receipts.md)).
- `memory_resolve_conflict` — arbitre les paires conflictuelles parquées par le **gel des contradictions** (voir la configuration `conflictFreeze.*`).
  Conclusions `winner` / `loser` / `both` : si une partie est déclarée vraie, l'autre se retire de la recherche ; `both` signifie
  qu'il s'agit de deux faits indépendants et les deux sont conservés.

Le cœur des capacités de mémoire (pipeline de distillation stratifiée, conception des prompts, architecture de stockage à double écriture) s'inspire du **MemoryCore** du projet
[TencentCloud/TencentDB-Agent-Memory](https://github.com/TencentCloud/TencentDB-Agent-Memory) ; merci au projet original d'avoir ouvert sa conception et son implémentation.

## License

[MIT](LICENSE)