[English](./README.md) | 简体中文
# dsh-lean
[](https://www.npmjs.com/package/dsh-lean)
[](#实测)
[](#账单的另一半在你打字之前就发出去了)
[](#实测)
[](#自己复现)
[](./LICENSE)
**DeepSeek 从 2026-08-16 起峰时按两倍计费,而峰时正好是上班时间。**
峰时是 UTC 01:00-04:00 和 06:00-10:00,其余时段是谷时,谷时正好是峰时的一半。
| 你的时区 | 按 2 倍计费的峰时 |
|---|---|
| UTC+8 北京、上海、新加坡 | 09:00-12:00 和 14:00-18:00 |
| UTC+9 东京、首尔 | 10:00-13:00 和 15:00-19:00 |
| UTC+0 伦敦 | 01:00-04:00 和 06:00-10:00 |
如果你按国内作息写代码,几乎每一行都是按贵的那档付的,中间只空出午休。把长时间跑的任务挪到晚上,账单直接减半,而且不用改任何配置。一场会话里再没有第二个 2 倍量级的杠杆。
看看你上一场会话到底付了多少,以及同样的运行放在谷时要多少。什么都不装,也没有任何数据离开你的机器。
```sh
npx dsh-lean audit
```
```
ran 08:42 to 08:42 UTC
3 of 3 requests hit peak hours (01-04 and 06-10 UTC), 100% of the tokens
you paid $0.000951
same run off-peak $0.000476 <- $0.000476 less, a 50% cut
```
## 账单的另一半在你打字之前就发出去了
**dsh 在读到你的提示词之前,已经发出去 8,246 个 token。其中 3,700 个是你的会话从来不会调用的工具。**
缓存未命中的单价是命中的 31 倍,而每场会话的第一个请求要按未命中价把整个工具 schema 前缀付一遍。一个 6 请求的任务,三次运行平均,把这段前缀付这一次就占了**整场账单的 46%**。
token 数不随价格变动,钱会。DeepSeek 于 2026-08-16 16:00 UTC 调价。在旧的统一价目表下,同样这些运行里这一笔占账单 52%,未命中与命中的比值是 50 倍。本页所有金额都按现行价目表给出。
同一行命令也会把这部分打出来,按哪个工具 schema 最费钱排序。
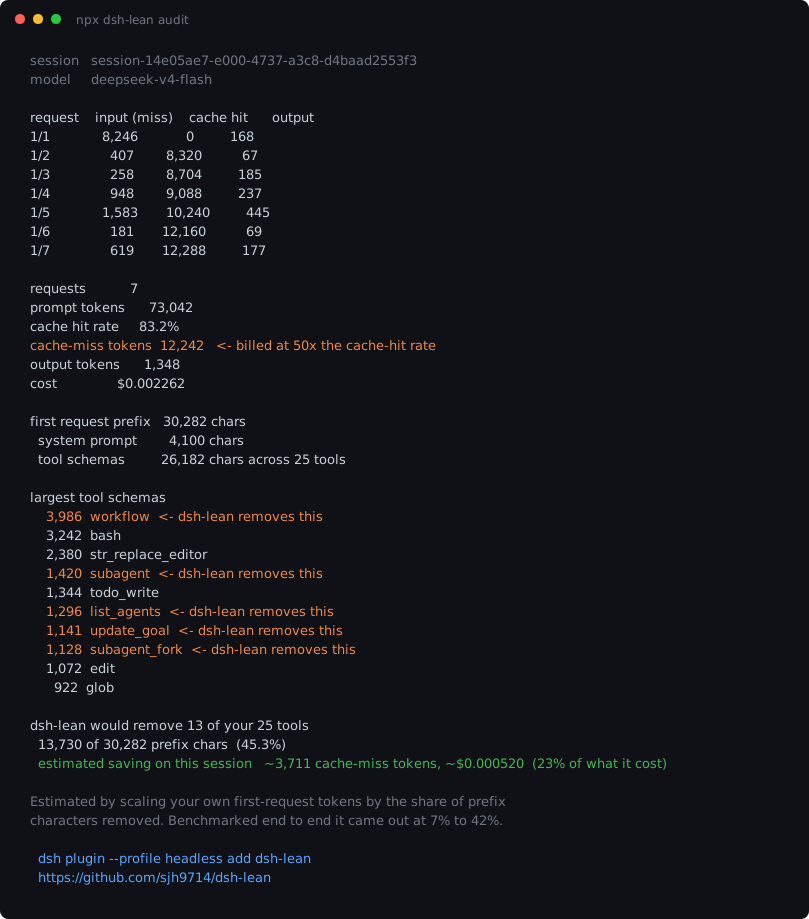 dsh-lean 就是那个修法:一个把这些工具行关掉的 preset,把提示词前缀压掉 53%。这值多少钱,实测在整场会话账单的 2% 到 41% 之间,而且下限是真的。
下面每个数字都来自 DeepSeek API 自己返回的用量统计,产出这些数字的测量脚本就在本仓库里。
## 实测
dsh 0.1.0-rc.6,测于 2026-08-16。共 32 次运行,每次都从任务的干净副本开始。
前缀的缩减是确定的,省下的钱不是,所以两个都列出来。
| 任务 | 每组运行次数 | 缓存未命中 token | 会话花费 | 交付物是否相同 |
|---|---|---|---|---|
| 一个问题,不改文件 | 3 | 8,600 到 4,912 **-43%** | $0.002106 到 $0.001243 **-41%** | 无测试可跑 |
| 修好 3 个失败测试 | 3 | 11,538 到 8,225 **-29%** | $0.003940 到 $0.003048 **-23%** | 相同,两边 9 个测试全过 |
| 按 16 个测试实现一个模块 | 7 | 10,376 到 7,470 **-28%** | $0.004866 到 $0.004787 **-2%** | 相同,两边 16 个测试全过 |
| 修好 3 个失败测试,跑在 `deepseek-v4-pro` 上 | 3 | 10,949 到 8,507 **-22%** | $0.010993 到 $0.008817 **-20%** | 相同,两边 9 个测试全过 |
缓存未命中 token 是测量本身,金额只是把这份测量按价目表折算,而价目表在 2026-08-16 变了。所以 `scripts/summarize.mjs` 每次都从已提交的 token 数重新算钱,而不是读回运行当时写死的金额,并且新旧两张表都打印。
**先看第三行,再看第一行。** 每个任务的缓存未命中 token 都降了 22% 到 43%,这是这个 patch 直接控制的部分。但把它变成钱并不可靠。在实现任务上,精简后的 agent 反而多走了步数,请求数 4.4 对 5.4,输出多了 24%,把省下的大部分又吃回去了。它的逐次花费区间是重叠的,默认 $0.003072 到 $0.005919,dsh-lean $0.003626 到 $0.006109,也就是说在那个任务上 dsh-lean 的某一次运行可能比默认还贵。它留在表里是因为它是诚实的下限,也是唯一要跑到每组 7 次才稳定下来的一行。
另外三行的区间是分开的。`node scripts/summarize.mjs` 会为每一行打印 n 和逐次区间,所以本页不可能只引用均值而不带离散度。
"交付物"那一列是承重的。它用来说明便宜下来不是因为少干了活,每一组配对运行里,任务自带的测试套件两边都是绿的。
会话第一个请求发出去的前缀。下面这些就是 `npx dsh-lean audit` 打印的、以及每一次提交的运行记录里的数字。
| | 工具数 | 系统提示词 | 工具 schema | 合计 |
|---|---|---|---|---|
| 默认 | 25 | 4,100 字符 | 26,182 字符 | 30,282 字符 |
| dsh-lean | 12 | 1,853 字符 | 12,452 字符 | **14,305 字符** |
## 为什么能省
DeepSeek 对缓存未命中的输入 token 收费是命中的 **31 倍**,`deepseek-v4-flash` 是每百万 $0.22 对 $0.007,从[价格页](https://api-docs.deepseek.com/quick_start/pricing)读取。这是谷时价;峰时是 01:00-04:00 和 06:00-10:00 UTC,正好翻倍,所以本页所有百分比在两个时段都成立,变的只是绝对金额。
每场会话的第一个请求,要按未命中价把整个前缀付一遍。在上面那个 6 请求的任务里,仅这一笔就占了**全部账单的 46%**(3 次运行平均),而且每次都恰好是 8,246 个 token。从第二个请求开始前缀就命中缓存,几乎不要钱。
所以前缀贵不是因为它大,而是因为它被按 31 倍价格付了一次。压缩它,是唯一能碰到账单里真正疼的那部分的杠杆。
**当初测量所依据的那张价目表已经没了。** 上面每一次运行都是在 2026-08-16 16:00 UTC DeepSeek 切换到峰谷计价之前测的,而且各档没有同步变动。`deepseek-v4-pro` 上,[deepseek-harness#2064](https://github.com/deepseek-ai/deepseek-harness/discussions/2064) 与账单后台做过对账,缓存命中从 $0.003625 涨到 $0.022,未命中从 $0.435 涨到 $0.66,未命中与命中的比值因此从 120 倍塌到 30 倍,flash 则从 50 倍变成 31 倍。
上面整张表已经按新表重算过了。调价对它做了什么值得直说,因为两个方向都有。
- 机制活下来了。缓存读取在 `v4-pro` 账单里的占比从 2.7% 升到 9.2%,而这个 patch 连那部分也一起缩,所以每场 pro 会话省下的绝对金额接近翻倍,$0.001233 到 **$0.002176**,百分比几乎没动,20.1% 到 19.8%。
- 下限更难看了。输出单价现在是未命中价的 3 倍而不是 2 倍,而稀释这个 patch 的正是输出,所以实现任务从省 7% 掉到省 **2%**。整体区间从 7% 到 42% 变成 **2% 到 41%**。
关掉一个工具行,系统提示词里为该工具生成的那段说明也会一并消失,所以系统提示词同时缩了 55%。
## 安装
```sh
dsh plugin --profile web add dsh-lean # web UI,装完在模式菜单里选 "Lean"
dsh plugin --profile headless add dsh-lean # 一次性 CLI,装完立即生效
```
直接从仓库装也行,不过上面的 npm 形式更好,预构建的包能跳过 pnpm 的 `allowBuilds` 构建授权步骤。
```sh
dsh plugin --profile web add "github:sjh9714/dsh-lean"
```
卸载用 `dsh plugin --profile remove dsh-lean`。在 web profile 上这样会留下已生成的 preset,想一并删掉就删 `$DSH_HOME/.agent-presets/lean`。
### 两个 profile 的机制不一样,这点很重要
headless profile 把工具挂在顶层行上,所以 bundle patch 直接就能关掉它们。
web profile 不是这样。它的 bundle 在顶层已经把那些行关了,然后挂上 `agent-presets`,真正的工具目录在 `standard` 这个 preset 的组合里面。**patch 层够不到 preset 组合内部。** 所以在 web profile 上,本包改为通过 dsh 自己的 `agentPresets.copy()` 授权 API 复制一份 `standard`,然后在副本里关掉 delegation 组、goal 工具和 jobs 工具。副本是从你实际拥有的那份 `standard` 复制的,所以 dsh 升级会被继承,而不是和一份内置的分叉渐行渐远。
它不会改你的默认 preset。默认值指向一个生成失败的 preset 会在挂载时直接报错,为了一点便利把 profile 弄坏不值得。"Lean" 会出现在模式菜单里,由你来选。
在 web profile 上实测,同一个提示词、同一个工作目录,各跑一次会话。
| | 工具数 | 系统提示词 | 工具 schema | 前缀 |
|---|---|---|---|---|
| Standard mode | 25 | 6,100 字符 | 26,336 字符 | 32,436 字符 |
| Lean | 12 | 3,492 字符 | 11,842 字符 | **15,334 字符** |
也就是砍掉 52.7%,和 headless 的比例一致。上面那张花费表是在 headless 上测的,因为基准测试脚本能在那里把一个任务从头驱动到尾;这里的 web 数字只包含前缀。
## 它关掉了什么
`tool-workflow`、`tool-subagent`、`tool-subagent-fork`、`tool-subagent-control`、`tool-subagent-list-agents`、`tool-goal`、`tool-jobs`、`tool-ralph`。
留下的是编码会话真正会用的那些。`bash`、`read`、`write`、`edit`、`glob`、`grep`、`str_replace_editor`、`todo_write`、`skill`、`read_image`、`web_search`、`exit_plan_mode`。
只关工具行。它们背后的服务照常挂载,所以依赖注入这些服务的东西仍然能解析到。
## 什么情况下别用
如果你在用子智能体、workflow、goal 系统、后台 job 或者 ralph 循环,就别装。这些正是它移除的部分,装了以后模型会告诉你没有这个工具。
还有两条要说清楚的限制。
- **稀释它的是输出,不是会话长度。** 它从每场会话开头砍掉的是一个固定量,大约 3,700 个未命中 token,会话里其他所有花费都会稀释它。稀释得最厉害的是输出,输出单价是未命中价的 3 倍。3 个请求的提问省 41%,4 个请求的实现任务只省 2%,所以变量不是请求数,是输出量。
- **在贵的模型上百分比并不会更高。** `deepseek-v4-pro` 各档单价都是 flash 的 3 倍,所以它买到的是 3 倍的绝对金额和同样的百分比。实测同一个任务,pro 省 20%,flash 省 23%。旧的统一表里 pro 的未命中命中比是 120 倍、flash 是 50 倍,看着像是该省更多的理由,其实不是;新表把两个模型都放在 30 倍左右,连这个错觉也一并消掉了。
## 自己复现
需要 DeepSeek API key 和 Node 18 以上。
```sh
git clone https://github.com/sjh9714/dsh-lean
cd dsh-lean
# 让基准测试离你自己的 dsh 配置远一点
export DSH_HOME="$PWD/.bench-home"
mkdir -p "$DSH_HOME"
cp ~/.dsh/.credentials.yaml "$DSH_HOME/"
node scripts/run-bench.mjs bench/task-01 # 默认
node scripts/run-bench.mjs bench/task-01 --patch cordis.patch.yml # dsh-lean
node scripts/summarize.mjs
# v4-pro 那一行,同样的任务跑在贵的模型上
node scripts/run-bench.mjs bench/task-01 --patch bench/pro.patch.yml
node scripts/run-bench.mjs bench/task-01 --patch bench/pro.patch.yml --patch cordis.patch.yml
```
每次运行都会把任务复制到一个全新的工作目录,走 `dsh --profile headless` 跑一遍,用任务自带的 `npm test` 验交付物,然后从 session 日志里把 token 数读回来。表格里每一次运行的原始结果都提交在 `bench/results/` 下。
`npx dsh-lean audit <工作目录>` 可以对你已经跑过的任意 dsh 会话打印同样的拆解,`npx dsh-lean audit --all` 则直接挑你最近的一次会话。
## 测量是怎么做的
dsh 每次运行都会在 `$DSH_HOME/sessions` 下写一个 `session.jsonl.zstd`。两类事件就够了。
- `assistant/chunk` 且 `chunk.type` 为 `usage` 的事件,带着厂商自己给的 `inputTokens`、`cacheReadTokens`、`outputTokens` 和 `reasoningTokens`。
- `request/header` 事件带着实际发出去的完整工具 schema 数组和系统提示词,上面那些前缀尺寸就是这么量出来的,不用额外花一次 API 调用。
`@deepseek-ai/dsh-llm-deepseek` 在记录之前就已经把 DeepSeek 的 `prompt_cache_hit_tokens` 和 `prompt_cache_miss_tokens` 分开了,所以缓存拆分用的是厂商的数字,不是估算。
## 许可
MIT